

De risico's van AI voor bedrijven: alternatieven voor OpenAI en de instellingen achter AI-agenten
Gegevensprivacy, naleving en vertrouwenslacunes in huidige AI-agentintegraties
“Wacht… stuur je je grootboekposten naar OpenAI?”
Dit was het eerste wat mijn vriendin vroeg toen ik haar Feel-Write liet zien , een AI-gestuurde dagboek-app die ik tijdens een hackathon in San Francisco had ontwikkeld.
Ik haalde mijn schouders op.
“Het was een hackathon met een AI-thema, en ik moest snel iets bouwen.”
Ze miste geen moment:
"Tuurlijk. Maar hoe kan ik vertrouwen op wat ik heb opgebouwd? Waarom organiseer je niet gewoon je eigen LLM?"
Dat hield mij tegen.
Ik was trots op hoe snel de app in elkaar was gezet. Maar deze ene vraag, en de vragen die erop volgden, onthulden alles wat ik dacht te weten over verantwoord bouwen met AI. Ook de jury van de hackathon had er aandacht voor.
Dat moment deed me beseffen hoe respectloos we zijn als we met AI bouwen, vooral met tools die gevoelige gegevens verwerken.
Ik realiseerde me iets groters:
Er wordt te weinig over vertrouwen gesproken als we met AI bouwen.
Haar antwoord bleef bij mij hangen. Georgia von Minden is datawetenschapper bij de ACLU, waar zij nauw samenwerkt met vraagstukken rondom persoonlijk identificeerbare informatie in de juridische en burgerrechtencontext. Ik heb haar inzicht altijd gewaardeerd, maar dit gesprek was anders.
Daarom vroeg ik Plus uit te leggen wat vertrouwen in deze context nu precies betekent, vooral wanneer AI-systemen met persoonsgegevens werken.
Ze vertelde mij:
Vertrouwen opbouwen kan lastig zijn, maar data governance is een goed beginpunt. Wie de eigenaar van de data is, hoe deze wordt opgeslagen en waarvoor deze wordt gebruikt, is allemaal belangrijk. Tien jaar geleden zou ik deze vraag anders hebben beantwoord. Maar vandaag de dag, met de enorme rekenkracht en enorme dataopslag, is brede inferentie een reële zorg. OpenAI heeft zo'n uitgebreide toegang tot zowel computers als data dat het gebrek aan transparantie voorzichtigheid oproept.
Als het gaat om persoonlijk identificeerbare informatie (PII), wijzen zowel regelgeving als gezond verstand op de noodzaak van sterk databeheer. Het versturen van persoonlijk identificeerbare informatie in API-aanroepen is niet alleen riskant, het kan ook in strijd zijn met deze regels en individuen in gevaar brengen.
Het deed me beseffen dat wanneer we met AI bouwen, vooral systemen die gevoelige menselijke gegevens verwerken, we niet alleen maar code schrijven.
Wij nemen beslissingen over privacy, autoriteit en vertrouwen.
Op het moment dat u gebruikersgegevens verzamelt, vooral persoonlijke gegevens zoals dagboeknotities, neemt u een verantwoordelijkheidsgevoel aan. Het gaat niet alleen om wat uw model kan. Het gaat erom wat er met die gegevens gebeurt, waar ze naartoe gaan en wie er toegang toe heeft. Verantwoord omgaan met gebruikersgegevens vergroot het vertrouwen van de gebruiker en verbetert de privacy.
De illusie van eenvoud
Tegenwoordig is het makkelijker dan ooit om iets te lanceren dat er slim uitziet. Met grote taalmodellen (LLM's) zoals OpenAI en andere kunnen ontwikkelaars binnen enkele uren AI-tools bouwen. Startups kunnen binnen een dag ‘AI-aangedreven’ functies lanceren. Hoe zit het met instellingen? Er wordt haast gemaakt met het integreren van deze agenten in de workflow.
Maar te midden van al dit enthousiasme wordt één ding vaak over het hoofd gezien: vertrouwen.
Wanneer mensen het over AI-agenten hebben , verwijzen ze vaak naar simpele wrappers rondom grote taalmodellen (LLM's). Deze agenten kunnen vragen beantwoorden, taken automatiseren of zelfs beslissingen nemen. Maar veel ervan worden haastig gebouwd, met weinig aandacht voor beveiliging, naleving van regelgeving of verantwoording.
Het feit dat je een OpenAI -product gebruikt, betekent niet automatisch dat het veilig is. Waar je echt op moet kunnen vertrouwen, is de volledige pipeline:
- Wie heeft de cover gemaakt?
- Hoe worden uw gegevens verwerkt?
- Wordt uw informatie opgeslagen, geregistreerd of, erger nog, gelekt?
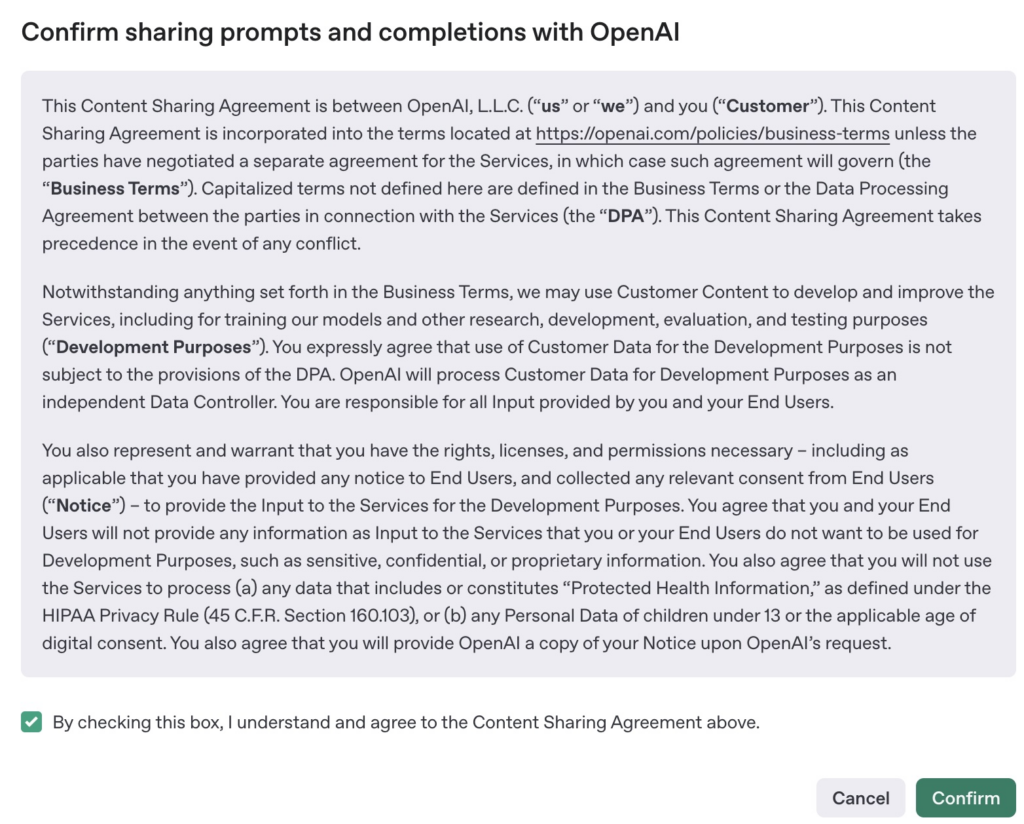
Ik gebruik de API van OpenAI zelf al voor klanttoepassingen. Onlangs kreeg ik gratis toegang tot de API aangeboden – tot 1 miljoen tokens per dag tot eind april – op voorwaarde dat ik mijn claimgegevens zou delen.
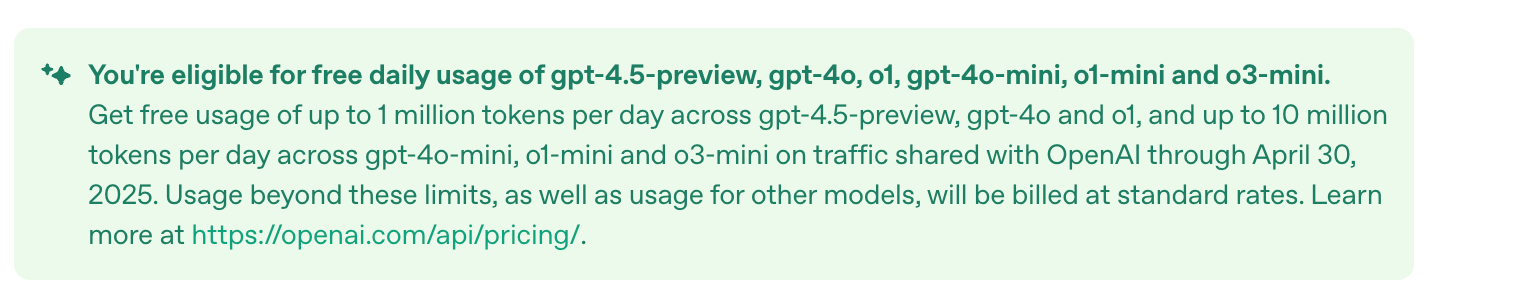
Ik stond op het punt om hiermee akkoord te gaan voor een persoonlijk zijproject, maar toen realiseerde ik me: als een oplossingsleverancier hetzelfde aanbod zou doen om kosten te besparen, zouden hun gebruikers geen idee hebben dat hun gegevens werden gedeeld. Op persoonlijk vlak lijkt dit misschien onschuldig. Maar binnen de context van de instelling? Dit is een ernstige schending van de privacy en mogelijk ook van contractuele of wettelijke verplichtingen.
Het is maar één ingenieur nodig die 'ja' zegt tegen een deal als deze, en uw klantgegevens zijn in de handen van iemand anders.
Enterprise AI verhoogt verwachtingen
Ik zie steeds meer SaaS-bedrijven en startups in ontwikkeltools experimenteren met AI-agents. Sommige laten goede resultaten zien, waarbij sommige AI-agents gebruikers in staat stellen hun eigen grote taalmodellen (LLM's) in te brengen, waardoor ze controle hebben over waar het model draait en hoe de data wordt verwerkt. Dit is een verstandige aanpak, vooral nu AI steeds belangrijker wordt binnen bedrijven.
Dit is de doordachte aanpak: je definieert de grenzen van het vertrouwen.
Maar niet iedereen is er zo enthousiast over.
Veel bedrijven maken simpelweg verbinding met de API van OpenAI, voegen een paar knoppen toe en noemen het 'enterprise ready'.
Waarschuwing: Dit is niet waar.
Wat kan er misgaan? veel.
Als u AI-agenten in uw infrastructuur integreert zonder de moeilijke vragen te stellen, zijn dit de potentiële risico's:
- DatalekUw claims kunnen gevoelige klantgegevens, API-sleutels of interne logica bevatten. Als u deze via een formulier van derden indient, kunnen deze worden blootgesteld.
In 2023 hebben Samsung-ingenieurs per ongeluk interne broncode en notities in ChatGPT geplakt ( Forbes ). Deze gegevens zouden nu deel kunnen uitmaken van toekomstige trainingssets, wat een aanzienlijk risico vormt voor intellectueel eigendom.
- Overtredingen van de nalevingHet indienen van persoonlijk identificeerbare informatie (PII) via een formulier als OpenAI zonder de juiste controles kan een schending van de Algemene Verordening Gegevensbescherming (AVG), HIPAA of uw contracten inhouden.
Elon Musks bedrijf, X, heeft dit op de harde manier geleerd. Ze lanceerden hun AI-chatbot "Grok" door alle berichten van gebruikers, inclusief die van EU-gebruikers, te gebruiken om hem te trainen, zonder behoorlijk toezicht. Toezichthouders grepen snel in. Onder druk werd de training van Grok in de EU stopgezet ( Politico ).
- vaag gedragNiet-deterministische agenten zijn moeilijk te corrigeren of te verklaren. Wat gebeurt er als een klant vraagt waarom een chatbot een verkeerde aanbeveling heeft gedaan of iets vertrouwelijks heeft onthuld? Om die vraag te kunnen beantwoorden, is transparantie nodig. Veel makelaars bieden dat vandaag de dag niet.
- Verwarring over data-eigendomWie is de eigenaar van het product? Wie registreert de gegevens? Wordt er door de dienstverlener bijgeschoold op basis van uw input?
Zoom werd in 2023 betrapt op precies dat. Ze wijzigden stilletjes hun gebruiksvoorwaarden om het gebruik van klantvergadergegevens voor het trainen van kunstmatige intelligentie toe te staan ( Fast Company ). Na een golf van publieke verontwaardiging draaiden ze het beleid terug, maar het diende als een herinnering dat vertrouwen van de ene op de andere dag verloren kan gaan.
- Beveiligingslekken in de verpakkingIn 2024 bleken tientallen implementaties van Flowise – een populaire low-code LLM-orkestratietool – blootgesteld aan het internet, veel zonder authenticatie (Cybersecurity-nieuws). Onderzoekers ontdekten dat API-sleutels, database-inloggegevens en gebruikersgegevens openbaar zijn. Dit is niet het probleem van OpenAI - dit is een probleem. Bouwers. Maar de eindgebruiker betaalt nog steeds de prijs.
- AI-functies die te ver gaanDe 'Recall'-functie van Microsoft, onderdeel van hun Copilot-uitrol, maakte automatisch screenshots van de activiteit van gebruikers om de AI-assistent te helpen vragen te beantwoorden (DubbelePulsar). Het leek nuttig... totdat veiligheidsexperts het als een privacynachtmerrie bestempelden. Microsoft moest snel terugkrabbelen en de functie optioneel maken.
Niet alles heeft OpenAI nodig.
OpenAI is een ongelooflijk krachtig platform. Maar het is niet altijd de beste oplossing.
Soms is een kleiner lokaal model voldoende. Soms werkt regelgebaseerde logica beter. De veiligste optie is vaak een optie die volledig binnen uw eigen infrastructuur en volgens uw eigen regels functioneert.
We moeten niet klakkeloos een groot taalmodel (LLM) invoeren en het een 'intelligente assistent' noemen.
In organisaties zijn vertrouwen, transparantie en controle geen optionele extra's , maar essentieel.
Er zijn steeds meer platforms die dit soort controle mogelijk maken. Salesforce Einstein 1 Studio ondersteunt nu de functie 'breng je eigen model mee' , waarmee je je Large Language Model (LLM) vanuit AWS of Azure kunt verbinden. IBM Watson stelt organisaties in staat om modellen intern te implementeren met volledige audit trails. Databricks, met MosaicML, laat je privé Large Language Models (LLM's) trainen binnen je cloud, zodat je gevoelige gegevens je infrastructuur nooit verlaten.
Zo zou echte AI voor bedrijven eruit moeten zien.
Conclusie
AI-agenten zijn ongelooflijk krachtig en maken workflows en automatisering mogelijk die we voorheen niet konden realiseren. Maar gemak bij de ontwikkeling betekent niet per definitie dat het ook veilig is, vooral niet als het gaat om gevoelige gegevens op grote schaal.
Voordat u dit fonkelnieuwe middel gaat gebruiken, moet u zichzelf het volgende afvragen:
- Wie beheert het model?
- Waar gaan de gegevens naartoe?
- Voldoen wij aan de regelgeving?
- Kunnen we controleren wat hij doet?
In het tijdperk van kunstmatige intelligentie is het grootste gevaar niet slechte technologie, maar blind vertrouwen.
Over de auteur
Ik ben Ellen, een machine learning engineer met 6 jaar ervaring. Momenteel werk ik bij een fintech-startup in San Francisco. Mijn achtergrond omvat functies in de datawetenschap bij consultancybureaus op het gebied van olie en gas, en het leiden van AI- en datatrainingsprogramma's in de regio Azië-Pacific, het Midden-Oosten en Europa.
Momenteel rond ik mijn masteropleiding Data Science af (ik studeer af in mei 2025) en ben actief op zoek naar mijn volgende kans als Machine Learning Engineer. Als u openstaat voor een doorverwijzing of connectie, zou ik dat zeer op prijs stellen!
Ik vind het geweldig om met behulp van AI een echte impact op de wereld te hebben en sta altijd open voor samenwerkingen op projectbasis.
Reacties zijn gesloten.