

Wanneer natuurkunde en financiën elkaar ontmoeten: AI gebruiken om de Black-Scholes-vergelijking op te lossen
Hier leest u hoe u met behulp van natuurkunde-gestuurde neurale netwerken financiële modellen kunt oplossen met behulp van Python.

Disclaimer : Dit is geen financieel advies. Ik heb een doctoraat in de lucht- en ruimtevaarttechniek met een sterke focus op machine learning; ik ben geen financieel adviseur. Dit artikel is uitsluitend bedoeld om de kracht van natuurkundig onderbouwde neurale netwerken (PINN's) in een financiële context te demonstreren.
Toen ik 16 jaar oud was, werd ik verliefd op natuurkunde. De reden was simpel maar krachtig: ik geloofde dat natuurkunde eerlijk was.
Ik heb nooit een fout gemaakt in een oefening omdat de lichtsnelheid van de ene op de andere dag veranderde, of omdat e x plotseling negatief kon worden. Elke keer dat ik een natuurkundig artikel las en dacht: "Dit lijkt nergens op te slaan", bleek achteraf dat ik degene was die het niet begreep.
Daarom is de natuurkunde altijd eerlijk, en om die reden is ze altijd perfect . De natuurkunde toont deze perfectie en eerlijkheid aan door middel van haar regels, die bekend staan als differentiaalvergelijkingen.
De eenvoudigste differentiaalvergelijking die ik ken is deze:
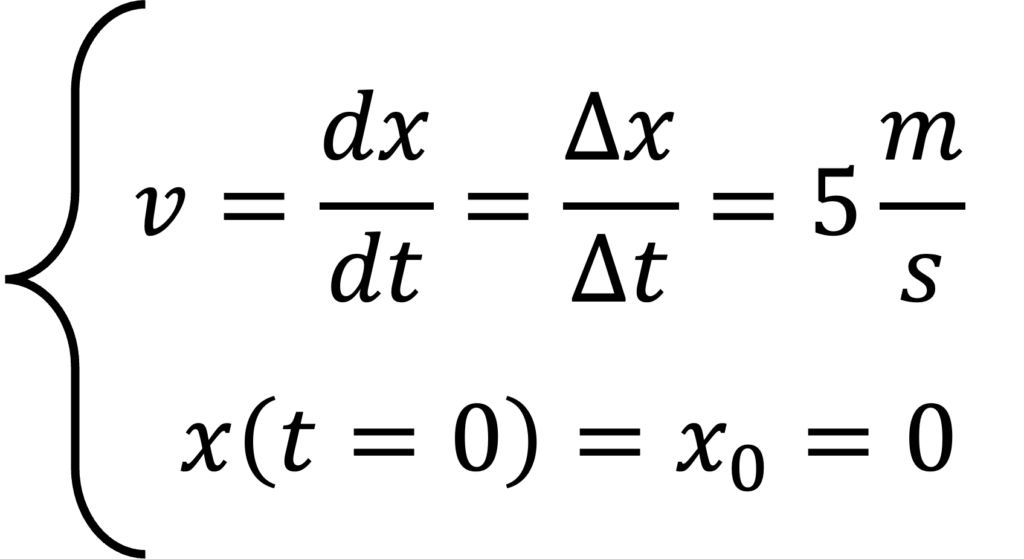
Het is heel simpel: we beginnen hier, x₀ = 0, op tijdstip t=0, en bewegen vervolgens met een constante snelheid van 5 m/s. Dit betekent dat we na één seconde 5 meter (of mijl, als je dat liever hebt) van het startpunt verwijderd zijn; na twee seconden 10 meter; na 43128 seconden… Ik denk dat je het snapt.
Zoals we al zeiden, het staat vast: perfect, perfect en onbetwistbaar. Maar stel je dit eens voor in het echte leven. Stel je voor dat je aan het wandelen bent of in de auto rijdt. Zelfs als je je best doet om een bepaalde snelheid aan te houden, zul je die nooit constant kunnen volhouden. Je gedachten zullen op bepaalde momenten alle kanten op schieten; je kunt afgeleid raken, je kunt stoppen voor een rood licht, en hoogstwaarschijnlijk een combinatie van deze dingen. Daarom is de eenvoudige differentiaalvergelijking die we eerder noemden wellicht niet voldoende. Wat we wél kunnen doen, is proberen je positie in de differentiaalvergelijking te voorspellen, maar dan met behulp van kunstmatige intelligentie . Dit concept is cruciaal voor het modelleren van complexe systemen.
Dit idee wordt toegepast in natuurkundig geïnformeerde neurale netwerken (PINN's). We zullen ze later in meer detail beschrijven, maar het basisconcept is dat we proberen de data te laten overeenkomen met wat we weten uit de differentiaalvergelijking die het fenomeen beschrijft. Dit betekent dat we onze oplossing dwingen om in het algemeen te voldoen aan wat we van de natuurkunde verwachten. Ik weet dat dit als zwarte magie klinkt, maar ik beloof dat het in de loop van dit artikel veel duidelijker zal worden.
En nu de grote vraag:
Wat hebben financiën te maken met natuurkunde en op natuurkunde gebaseerde neurale netwerken?
Welnu, het blijkt dat differentiaalvergelijkingen niet alleen nuttig zijn voor diegenen die geïnteresseerd zijn in de wetten van het natuurlijke universum; ze kunnen ook van pas komen in financiële modellen . Het Black-Scholes -model gebruikt bijvoorbeeld een differentiaalvergelijking om, onder bepaalde strikte voorwaarden, de prijs van een calloptie te bepalen en zo een risicovrije portefeuille te verkrijgen.
Het doel van deze zeer complexe inleiding was tweeledig:
- Ik verwar je een beetje, zodat je verder kunt lezen :)
- Wees nieuwsgierig genoeg om te zien waar dit allemaal naartoe gaat.
Ik hoop dat het gelukt is 😁. Als u dat doet, zal de rest van het artikel als volgt verlopen:
- Wij zullen bespreken Black-Scholes-model, de aannames ervan en de differentiaalvergelijking
- We zullen het hebben over Op natuurkunde gebaseerde neurale netwerken (PINN's), waar het vandaan komt en waarom het nuttig is
- We zullen ons eigen algoritme ontwikkelen dat PINN traint op Black-Scholes met behulp van Python و Fakkel و OOP.
- We laten de resultaten van ons algoritme zien.
Ik ben opgewonden! Naar het lab! 🧪
1. Het Black-Scholes-model: een diepgaande blik
Als je het originele artikel over het Black-Scholes-model wilt lezen, kun je het hier vinden . Absoluut de moeite waard 🙂
Oké, nu moeten we de financiële wereld waarin we ons bevinden begrijpen , welke variabelen er zijn en welke regels er gelden. Het is cruciaal om de fundamenten van financiën en de relatie ervan met Black-Scholes te begrijpen.
Ten eerste bestaat er in de financiële wereld een krachtig instrument genaamd een calloptie . Een calloptie geeft je het recht (maar niet de verplichting) om een aandeel te kopen tegen een specifieke prijs in de toekomst (laten we zeggen over een jaar), die de uitoefenprijs wordt genoemd.
Laten we daar eens even over nadenken. Stel dat de aandelenkoers vandaag $ 100 bedraagt. Laten we er ook vanuit gaan dat we een calloptie bezitten met een uitoefenprijs van $100. Stel je nu voor dat de aandelenkoers binnen een jaar stijgt naar $ 150. Dat is geweldig! We kunnen deze calloptie gebruiken om de aandelen te kopen en ze vervolgens onmiddellijk weer te verkopen! We hebben zojuist een winst gemaakt van $150 - $100 = $50. Als de aandelenkoers daarentegen binnen een jaar daalt tot $ 80,-, dan kunnen we dat niet doen. Eigenlijk is het beter om helemaal geen gebruik te maken van ons recht op aankoop, om geen geld te verliezen.
Als we er even over nadenken, lijkt het idee om aandelen te kopen en opties te verkopen perfect in balans . Wat ik bedoel is dat de willekeurigheid van de aandelenkoers (het feit dat deze stijgt en daalt) kan worden beperkt door het juiste aantal opties aan te houden. Dit noemen we delta-hedging, en het is een fundamentele strategie voor risicomanagement.
Op basis van een aantal aannames kunnen we een eerlijke optieprijs afleiden om een risicovrije portefeuille te verkrijgen . Dit concept is fundamenteel voor het Black-Scholes-model.
Ik wil u niet vervelen met alle details van de afleiding (het is eerlijk gezegd niet moeilijk om het originele artikel te volgen), maar de differentiaalvergelijking voor de risicoloze portefeuille ziet er als volgt uit:
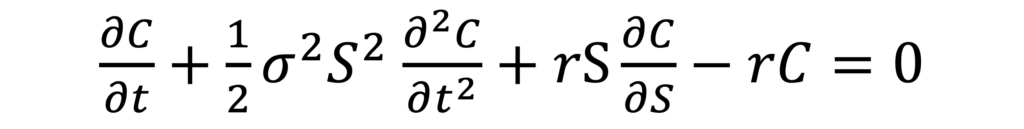
waar:
Cis de optieprijs op tijdstip tsigmaHet is de volatiliteit van het aandeel.rHet is het risicoloze tarief.tis tijd (met t=0 nu en T op de einddatum)Sis de huidige aandelenkoers
Uit deze vergelijking kunnen we de reële prijs van een calloptie voor een risicoloze portefeuille afleiden. De vergelijking is gesloten en analytisch en ziet er als volgt uit:
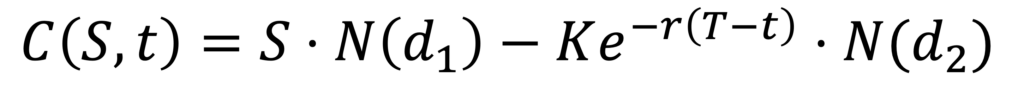
met:
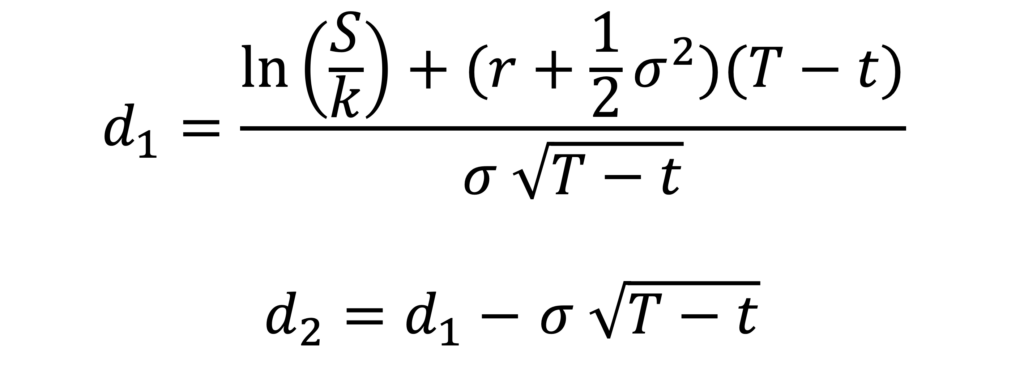
waarbij N(x) de cumulatieve verdelingsfunctie (CDF) is van de standaardnormale verdeling, K de uitoefenprijs en T de vervaldatum.
Dit is bijvoorbeeld een grafiek van de aandelenkoers (x) versus de calloptie (y) , volgens het Black-Scholes-model.
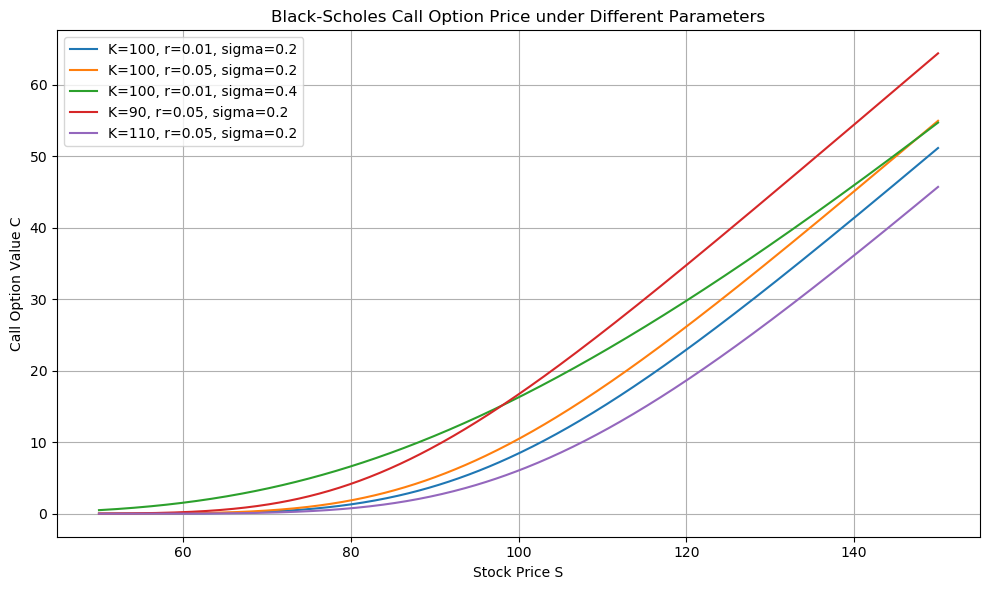
Dat klinkt allemaal geweldig, maar wat heeft dit met natuurkunde en PINN te maken? De vergelijking lijkt analytisch, dus waarom PINN? Waarom kunstmatige intelligentie? Waarom lees ik dit eigenlijk? Het antwoord staat hieronder 👇:
2. Fysica-geïnformeerde neurale netwerken
Als je geïnteresseerd bent in Physics Informed Neural Networks (PINNs), kun je het originele artikel hier bekijken . Het is zeker de moeite waard om te lezen. 🙂
De bovenstaande vergelijking is analytisch , maar vertegenwoordigt wederom een eerlijke prijs in een ideaal scenario. Wat gebeurt er als we dit even buiten beschouwing laten en proberen de optieprijs te schatten op basis van de aandelenkoers en het tijdstip? We zouden bijvoorbeeld een feedforward neuraal netwerk kunnen gebruiken en dit trainen met behulp van backpropagatie. Deze aanpak vormt de basis voor het gebruik van neurale netwerken bij de prijsbepaling van opties.
Met dit trainingsmechanisme minimaliseren we de fout:
L = |Estimated C - Real C|:
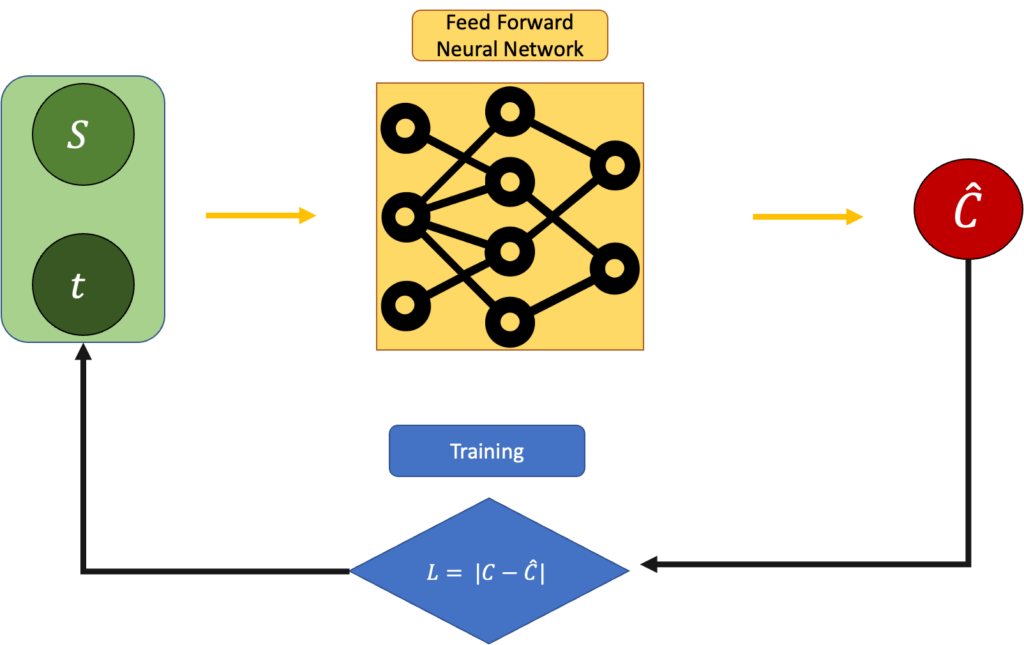
Dat is goed en het is de eenvoudigste aanpak die je met een neuraal netwerk kunt gebruiken. Het probleem hier is dat we de Black-Scholes-vergelijking volledig negeren. Is er dan een andere manier? Kunnen we ze samenvoegen?
Dat kan natuurlijk wel, als we de fout instellen op:
L = |Estimated C - Real C|+ PDE(C,S,t)
waarbij PDE(C,S,t) is:
Deze waarde moet zo dicht mogelijk bij 0 liggen:
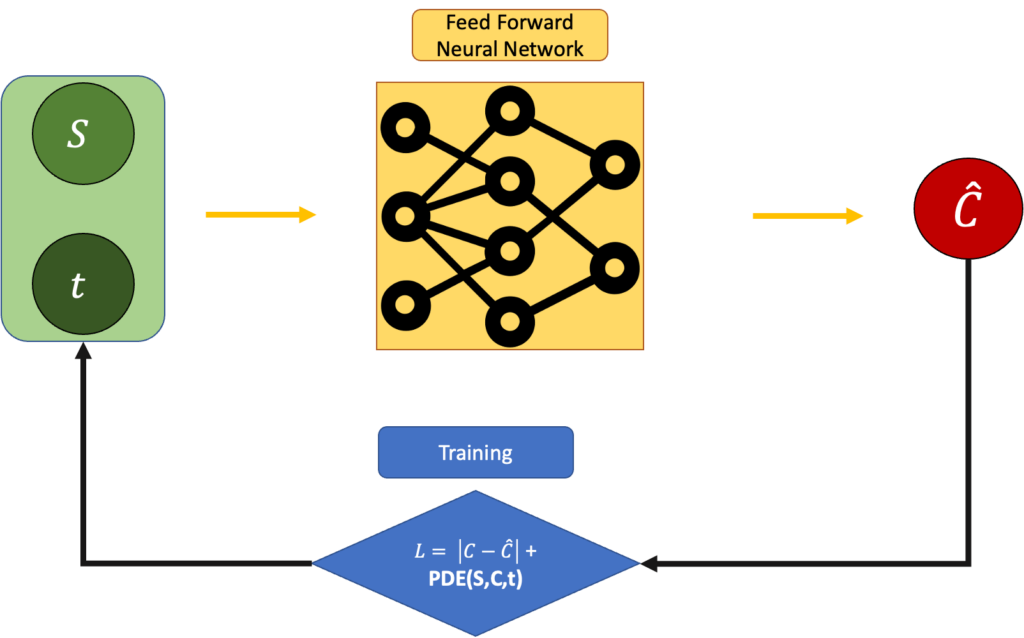
Maar de vraag blijft. Waarom is dit ‘beter’ dan de eenvoudige Black-Scholes-vergelijking? Waarom gebruiken we niet gewoon de differentiaalvergelijking? Omdat het oplossen van een differentiaalvergelijking soms niet garandeert dat je de "ware" oplossing krijgt. De natuurkunde benadert zaken doorgaans, en doet dat op een manier die een verschil kan creëren tussen wat we verwachten en wat we zien. Dit is de reden waarom natuurkunde-geïnformeerde neurale netwerken (PINN's) zo'n verbazingwekkend en geweldig hulpmiddel zijn: je probeert de natuurkunde te evenaren, maar je bent strikt in het feit dat de resultaten moeten overeenkomen met wat je 'ziet' in je dataset. Deze integratie van het fysieke model en experimentele gegevens is wat deze aanpak uniek maakt.
In ons geval kan het zo zijn dat we, om een risicoloze portefeuille te verkrijgen, tot de conclusie komen dat het theoretische Black-Scholesmodel niet perfect aansluit bij de rommelige, bevooroordeelde of onvolledige marktgegevens die we waarnemen. Misschien is volatiliteit niet constant. Misschien is de markt niet efficiënt. Misschien kloppen de aannames achter de vergelijking niet. Hierbij kan een aanpak als PINN van pas komen. We vinden niet alleen een oplossing die voldoet aan de Black-Scholes-vergelijking, maar we ‘vertrouwen’ ook wat we uit de data zien. Dit zorgt voor een model dat flexibeler is en beter kan worden aangepast aan de werkelijke marktomstandigheden.
Oké, genoeg theorie. Laten we programmeren. 👨💻
3. Praktische toepassing met Python
De volledige code, samen met een uitstekend README.md-bestand, een handig werkboek en zeer duidelijke benchmarkcode, vind je hier . Deze code is specifiek ontworpen om de Black-Scholes-vergelijking op te lossen met behulp van PINN-neurale netwerken, een geavanceerde techniek op het gebied van financiële modellering.
Let op: dit onderdeel is vrij intensief (veel code). Als u niet geïnteresseerd bent in software, kunt u gerust doorgaan naar het volgende hoofdstuk. Ik zal de resultaten op een eenvoudigere manier laten zien :)
Heel erg bedankt dat je het tot hier hebt gehaald ❤️
Laten we eens kijken hoe we dit kunnen implementeren. Laten we nu eens kijken hoe we deze techniek kunnen toepassen op het oplossen van Black-Scholes-vergelijkingen, waarbij we ons richten op de praktische en gedetailleerde aspecten.
3.1 Config.json-bestand
De volledige code kan worden uitgevoerd met behulp van een zeer eenvoudig configuratiebestand, dat ik config.json heb genoemd.
U kunt het plaatsen waar u maar wilt, zoals we later zullen zien.
Dit bestand is essentieel omdat het alle parameters definieert die onze simulatie, datageneratie en modeltraining bepalen. Ik zal kort uitleggen wat elke waarde vertegenwoordigt:
K: Uitvoeringsprijs – De prijs waartegen de optie u het recht geeft om de aandelen in de toekomst te kopen.T: Tijd tot de vervaldatum, in jaren. toestemmingT = 1.0Dit betekent dat de optie over één eenheid (bijvoorbeeld één jaar) afloopt.r: risicoloze rente Wordt gebruikt om toekomstige waarden te disconteren. Dit is de rentevoet die we in onze simulatie specificeren.sigma: fluctuatie Het aandeel, dat bepaalt hoe moeilijk het is om de koers van het aandeel te voorspellen of hoe "risicovol" het is. Nogmaals, dit is een simulatieparameter.N_data: nummer synthetische datapunten die we willen creëren voor training. Dit bepaalt ook de grootte van het patroon.min_Sوmax_S: Aandelenkoersbereik Welke we willen bemonsteren bij het maken van synthetische data. Onze minimale en maximale aandelenprijs.bias: Optionele compensatie toegevoegd aan optieprijzen, om een systematische verschuiving in de gegevens te simuleren. Dit wordt gedaan om een contrast te creëren tussen de echte wereld en de Black-Scholes-gegevens.noise_variance: geluidsniveau Toegevoegd aan optieprijzen om metingen of marktruis te simuleren. Deze parameter is om dezelfde reden toegevoegd als hiervoor.epochs: nummer herhalingen waarop het model wordt getraind.lr: leertempo Voor de weldoener. Hiermee bepaalt u hoe snel het model tijdens de training wordt bijgewerkt.log_interval:Het aantal keren (in termen van leeftijden) dat we willen Afdrukken van records Om de voortgang van de training te monitoren.
Elk van deze parameters vervult een specifieke rol. Sommige parameters bepalen de financiële wereld die we simuleren, terwijl andere bepalen hoe ons neurale netwerk met die wereld samenwerkt. Kleine aanpassingen kunnen hier tot een compleet ander gedrag leiden, waardoor dit bestand zowel krachtig als gevoelig wordt. Wanneer u de waarden van dit JSON-bestand wijzigt, zal de uitvoer van uw code radicaal veranderen.
3.2 main.py (main.py-bestand)
Laten we nu eens kijken hoe de rest van de code deze configuratie in de praktijk gebruikt.
Het grootste deel van onze code komt uit main.py , om je PINN-netwerk te trainen met Torch, en black_scholes.py.
Dit is het main.py-bestand:
Wat u dus kunt doen, is:
- Maak uw eigen config.json-bestand
- opdracht uitvoeren
python main.py --config config.json
Het bestand main.py wordt door veel andere bestanden gebruikt.
3.3 black_scholes.py en zijn plug-ins
De toepassing van het Black-Scholes-model bevindt zich in het bestand black_scholes.py :
Dit bestand kan worden gebruikt om het model te bouwen, trainen, exporteren en voorspellen.
De functie maakt ook gebruik van een aantal hulpbestanden, zoals data.py, loss.py en model.py.
Er staat een Torch-sjabloon in het bestand. model.py:
De dataconstructor (beschouw het configuratiebestand) bevindt zich in het bestand data.py :
De ingebouwde verliesfunctie, die de afwijkingswaarde bevat, is te vinden in loss.py. Deze functie is essentieel voor het verbeteren van de nauwkeurigheid van het model.
4. Resultaten
Wanneer we main.py uitvoeren, wordt ons feedforward neurale netwerk (FFNN) getraind en krijgen we het volgende:
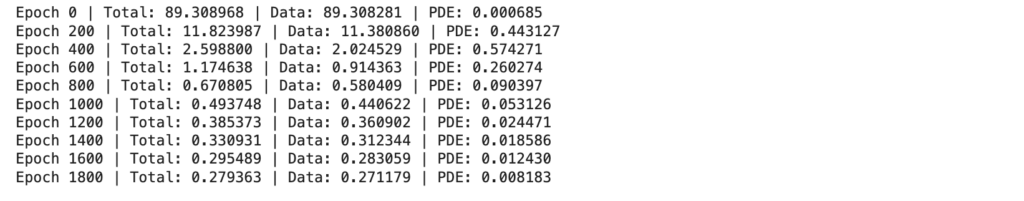
Zoals u kunt zien, is de modelfout niet precies 0, maar de PDE-vergelijking van het model is veel kleiner dan de data. Dit betekent dat het model onze voorspellingen (op natuurlijke wijze) sterk dwingt om te voldoen aan de differentiaalvergelijkingen. Dat is precies wat we al eerder zeiden: we verbeteren de prestaties op basis van de gegevens die we hebben en op basis van het Black-Scholes-model.
Kwalitatief kunnen we een hoge match waarnemen tussen de ruisige en bevooroordeelde (redelijk realistische) dataset uit de echte wereld en het PINN-netwerk.
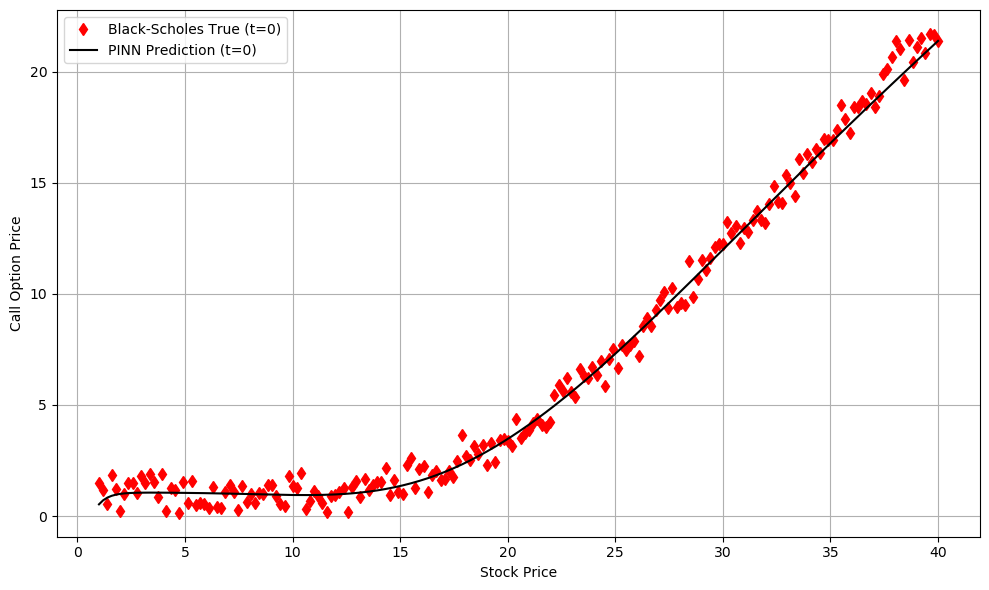
Dit zijn de resultaten als t = 0 en de aandelenkoers verandert met de calloptie op een vaste waarde van t. Best wel gaaf, toch? Maar het is nog niet voorbij! U kunt de resultaten met behulp van de bovenstaande code op twee manieren bekijken:
- Spelen met velen parameters bevindt zich in config.json
- Bekijk voorspellingen op t> 0
Ik luister! :)
5. Conclusies
Hartelijk dank dat u hier bent gekomen. Echt, dit was een lange reis 😅
Dit is wat we in dit artikel hebben behandeld:
- We begonnen met natuurkunde.en hoe de wetten ervan, opgeschreven als differentiaalvergelijkingen, eerlijk, mooi en (meestal) voorspelbaar zijn.
- We zijn overgestapt naar financiënEn we ontmoetten het Black-Scholesmodel: een differentiaalvergelijking die erop gericht is opties op een risicoloze manier te prijzen.
- We onderzochten natuurkunde-geïnformeerde neurale netwerken (PINN's)., een type neuraal netwerk dat niet alleen gegevens aanpast, maar ook de onderliggende differentiaalvergelijking respecteert. PINN's zijn een krachtig hulpmiddel voor het modelleren van complexe systemen.
- We hebben alles in Python gedaan.Met behulp van PyTorch en een schone benchmarkdatabase kunt u parameters aanpassen, synthetische gegevens genereren en uw eigen PINN's trainen om de Black-Scholes-vergelijking op te lossen.
- Wij hebben de resultaten gefotografeerd. We zagen hoe het netwerk leerde om niet alleen de ruis in de data te verwerken, maar ook het gedrag dat verwacht werd op basis van de Black-Scholes-vergelijking.
Ik weet dat het niet makkelijk is om dit allemaal in één keer te verwerken. Op sommige punten was ik noodgedwongen beknopt, misschien wel korter dan nodig. Mocht je echter een beter begrip willen, kijk dan nogmaals in de GitHub-map. Zelfs als je niet geïnteresseerd bent in de software, vind je daar een duidelijk README.md-bestand en een eenvoudig voorbeeld/BlackScholesModel.ipynb- bestand dat het project stap voor stap uitlegt.

Reacties zijn gesloten.