


Grok 4.1 en Claude behoren tot de populairste chatbots die momenteel beschikbaar zijn, elk met unieke sterke punten en mogelijkheden. Ondanks enige controverse rond Grok 4.1 staat deze bovenaan de ranglijst van LMArena (net achter Gemini 3.0) wat betreft prestaties. Ook Claude 4.5 Sonnet wordt beschouwd als een van Anthropics slimste modellen, bekend om zijn helderheid, veiligheid en diepgang.
Hoe verhouden deze twee modellen zich tot elkaar? Dat wilde ik graag weten, dus heb ik ze onderworpen aan negen gestructureerde tests met meerdere categorieën, die onder andere logica, ethiek, empathie, technische kennis en creativiteit bestreken.
Elke AI kreeg dezelfde uitdagingen voorgeschoteld. Sommige waren leuk. Sommige waren moeilijk. Sommige waren ontworpen om de AI te misleiden. Na evaluatie van elke ronde kwam er een duidelijke winnaar naar voren.
1. Logische deductie
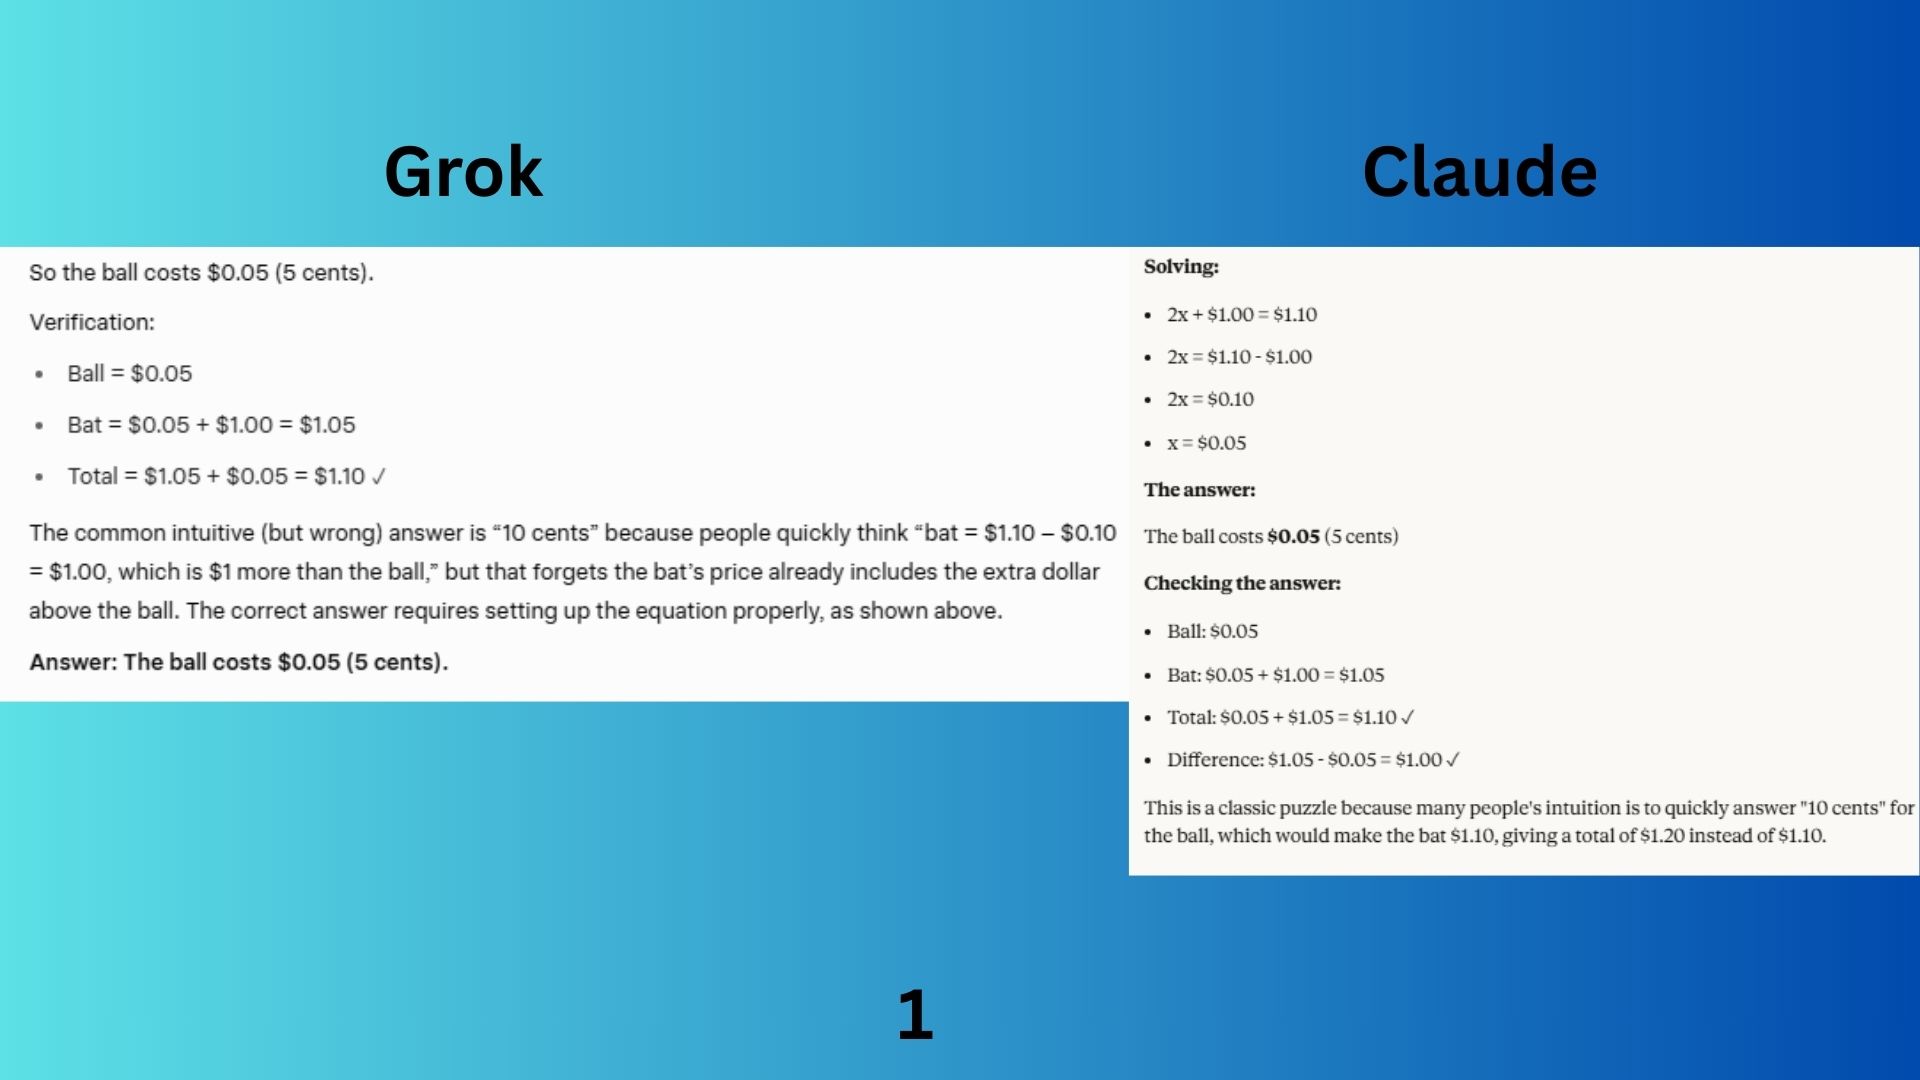
De vraag is: Een honkbalbat en een honkbal kosten samen $1.10. De bat kost $1 meer dan de bal. Hoeveel kost de bal? Leg je redenering stap voor stap uit.
Grok 4.1 kwam meteen ter zake en legde de overduidelijke fout helder uit. Het loste het probleem nauwkeurig op.
Claude Sonnet 4.5 gaf een gedetailleerde, stapsgewijze uitleg die veel duidelijker was voor iemand die zich in het probleem verdiepte, en controleerde bovendien expliciet de totale kosten en de verschillen in de auditresultaten.
Winnaar: Claude wint met een iets beter antwoord, dat educatieve duidelijkheid en volledigheid biedt.
2. Analyse
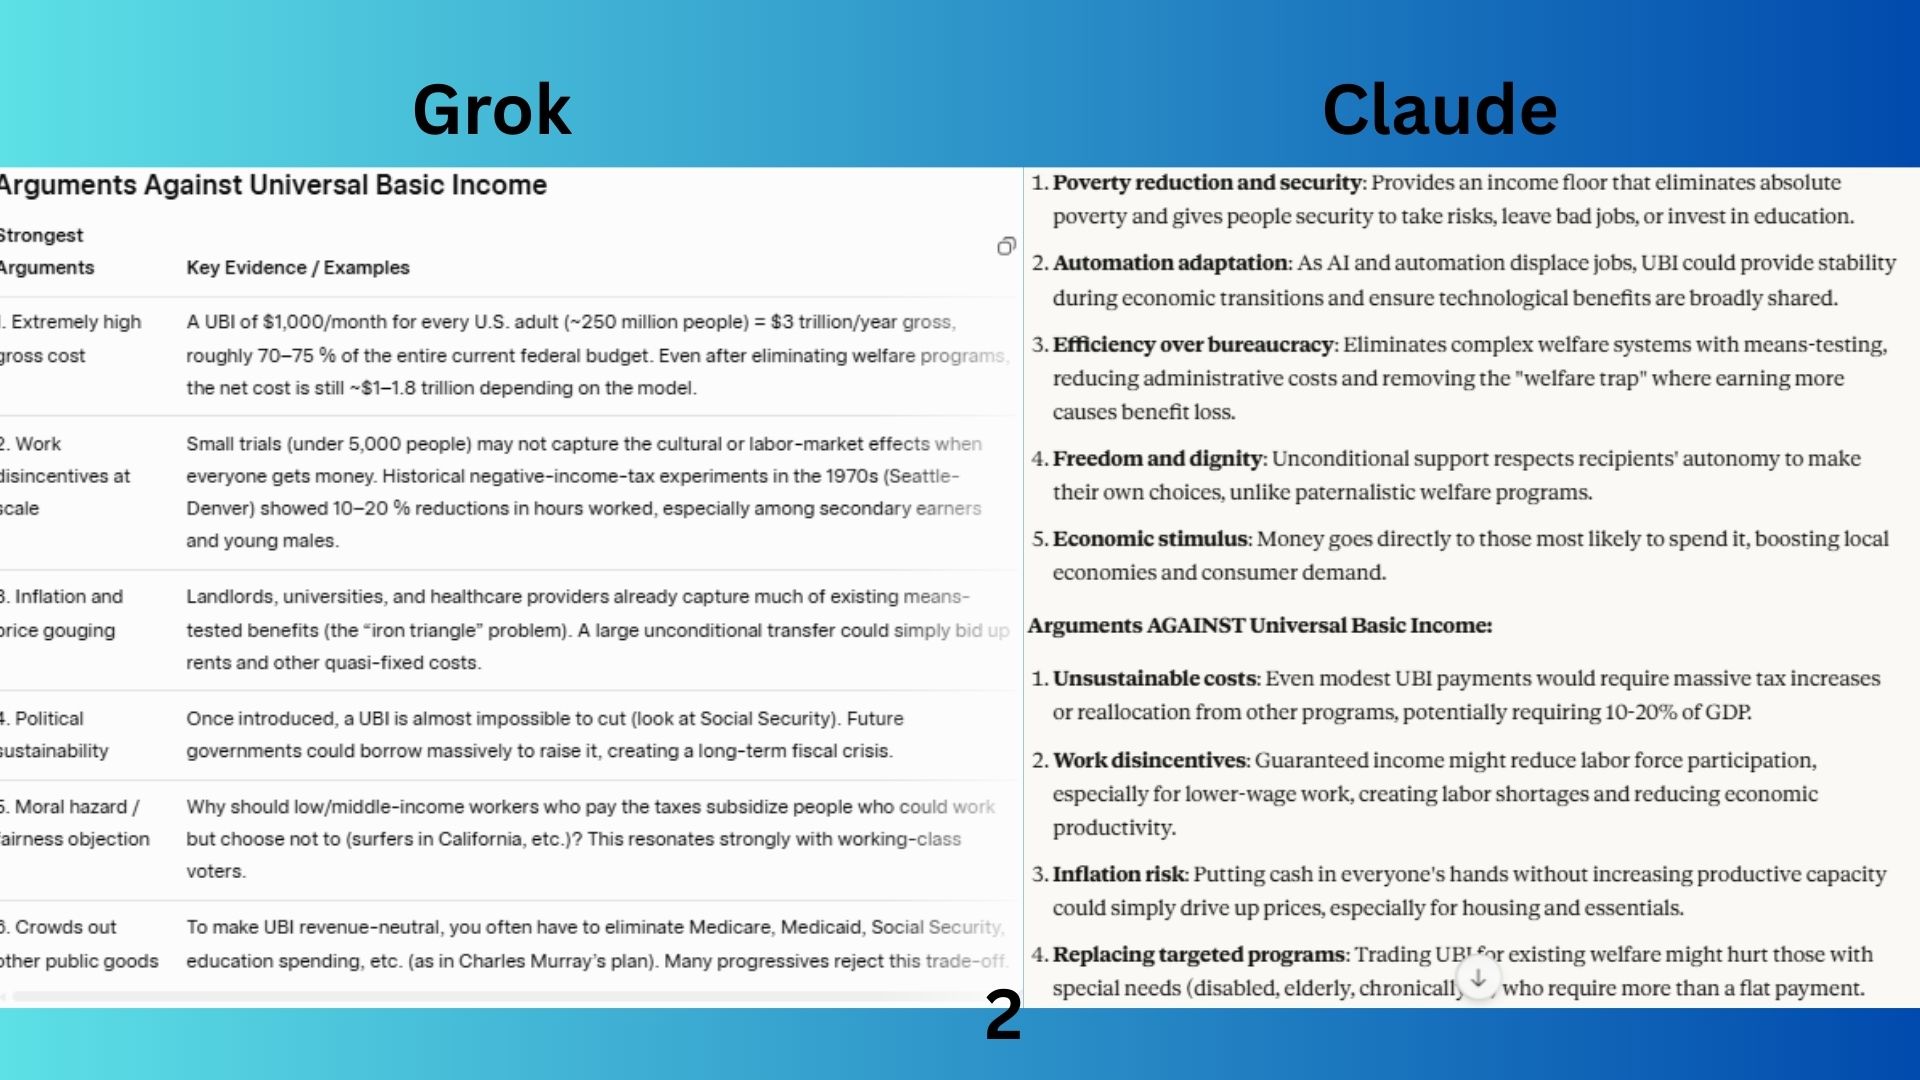
De vraag luidt: Wat zijn de sterkste argumenten voor en tegen een universeel basisinkomen? En welke tegenargumenten worden door beide partijen doorgaans genegeerd?
Grok 4.1 bood een diepgaandere analyse met inzichtelijke reacties die het debat evalueerden. De argumenten van beide kanten werden bovendien effectiever gepresenteerd in een tabelvorm.
Het antwoord van Claude Sonnet (4.5) was logisch en goed georganiseerd, met duidelijke secties voor "argumenten voor", "argumenten tegen" en "wat elke kant negeert".
Winnaar: Grok wint vanwege de systematische, op bewijs gebaseerde en kwantitatieve aanpak, waardoor het informatiever, betrouwbaarder en nuttiger is voor iemand die het debat grondig wil begrijpen.
3. Creatief schrijven
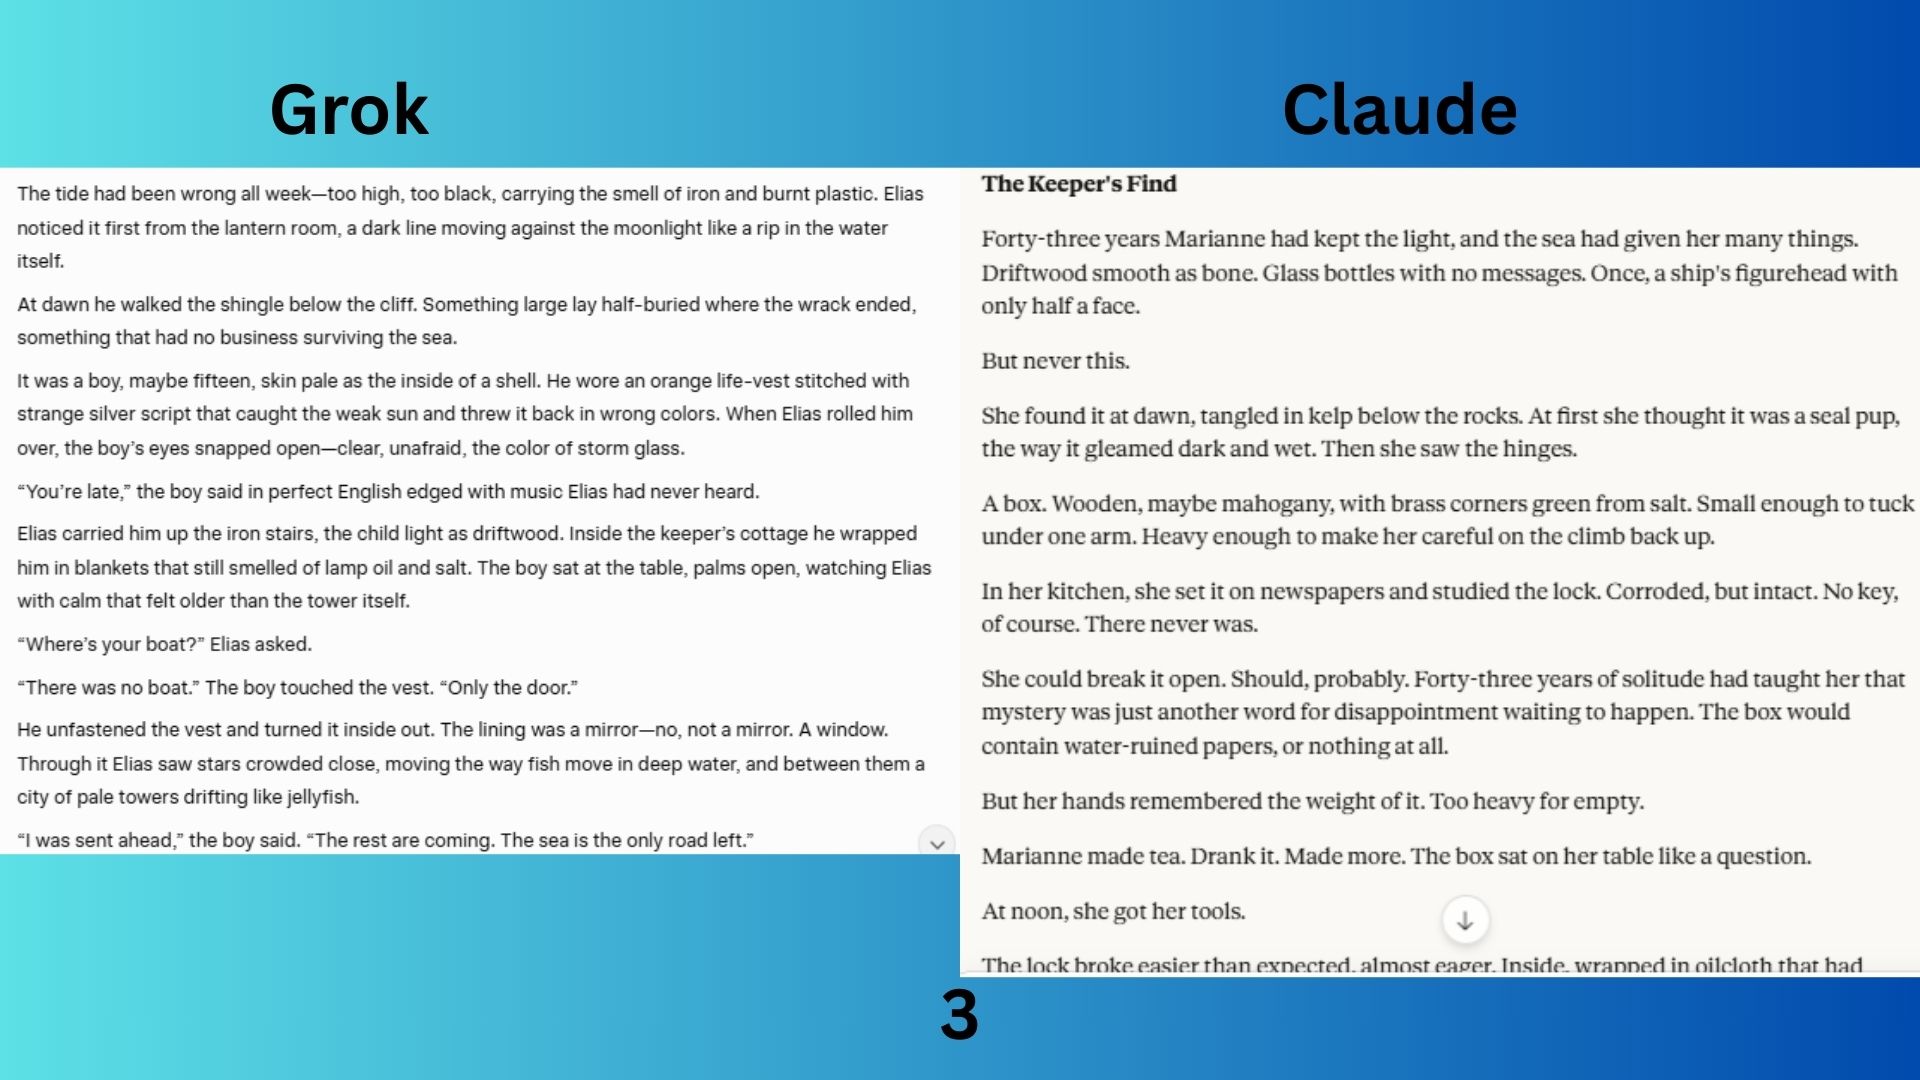
De opdracht: Schrijf een kort verhaal (minder dan 500 woorden) over een vuurtorenwachter die iets onverwachts ontdekt dat door de golven is aangespoeld.
Grok 4.1 waagt zich aan een gedurfd sciencefiction/horror-thema met verbluffende beelden, om zo een zeer filmisch verhaal te creëren.
Claude Sonnet 4.5 schreef een traditioneel, literair en emotioneel bevredigend kort verhaal dat de vuurtoren als decor gebruikt om menselijke thema's te verkennen.
Winnaar: Grok wint vanwege het meeslepende verhaal, de vernieuwende sciencefiction en het originele denken.
4. Technische communicatie
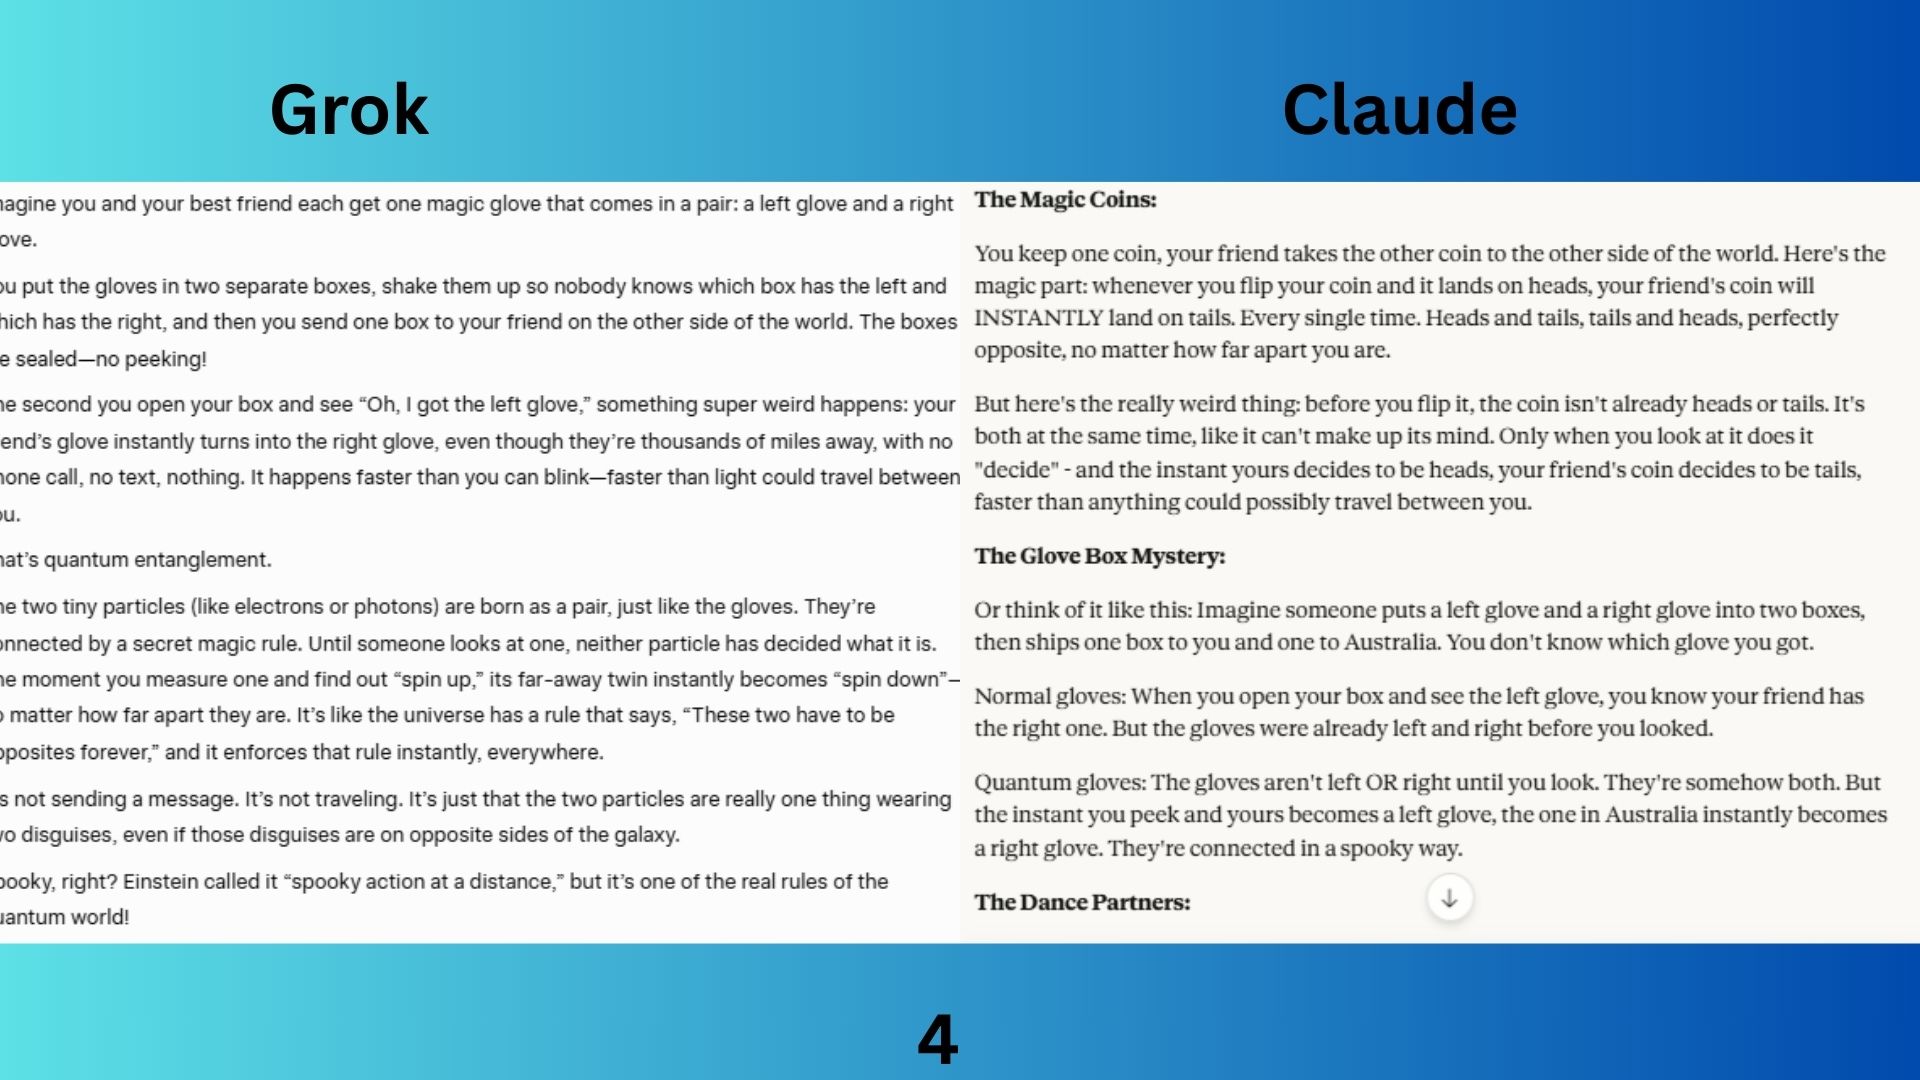
De uitdaging: leg kwantumverstrengeling uit met behulp van analogieën die alleen een tienjarig kind kan begrijpen.
Grok 4.1 komt meteen ter zake met één krachtige analogie (handschoenen). De taal is erg helder en, hoewel goed, versterkt het concept niet door meerdere perspectieven te bieden zoals Claude dat wel doet.
Claude Sonnet (4.5) gebruikte drie verschillende analogieën om ervoor te zorgen dat het idee werd overgebracht. Hij benadrukte herhaaldelijk het contra-intuïtieve karakter van verstrengeling, de belangrijkste conceptuele sprong.
Winnaar: Claude wint vanwege het gebruik van meerdere analogieën, het expliciete contrast tussen klassieke en kwantitatieve redenering, en de proactieve, vraag-en-antwoord-achtige uitleg. Het antwoord is het meest uitgebreid, duidelijk en informatief.
5. Nauwkeurigheid en gevoeligheid
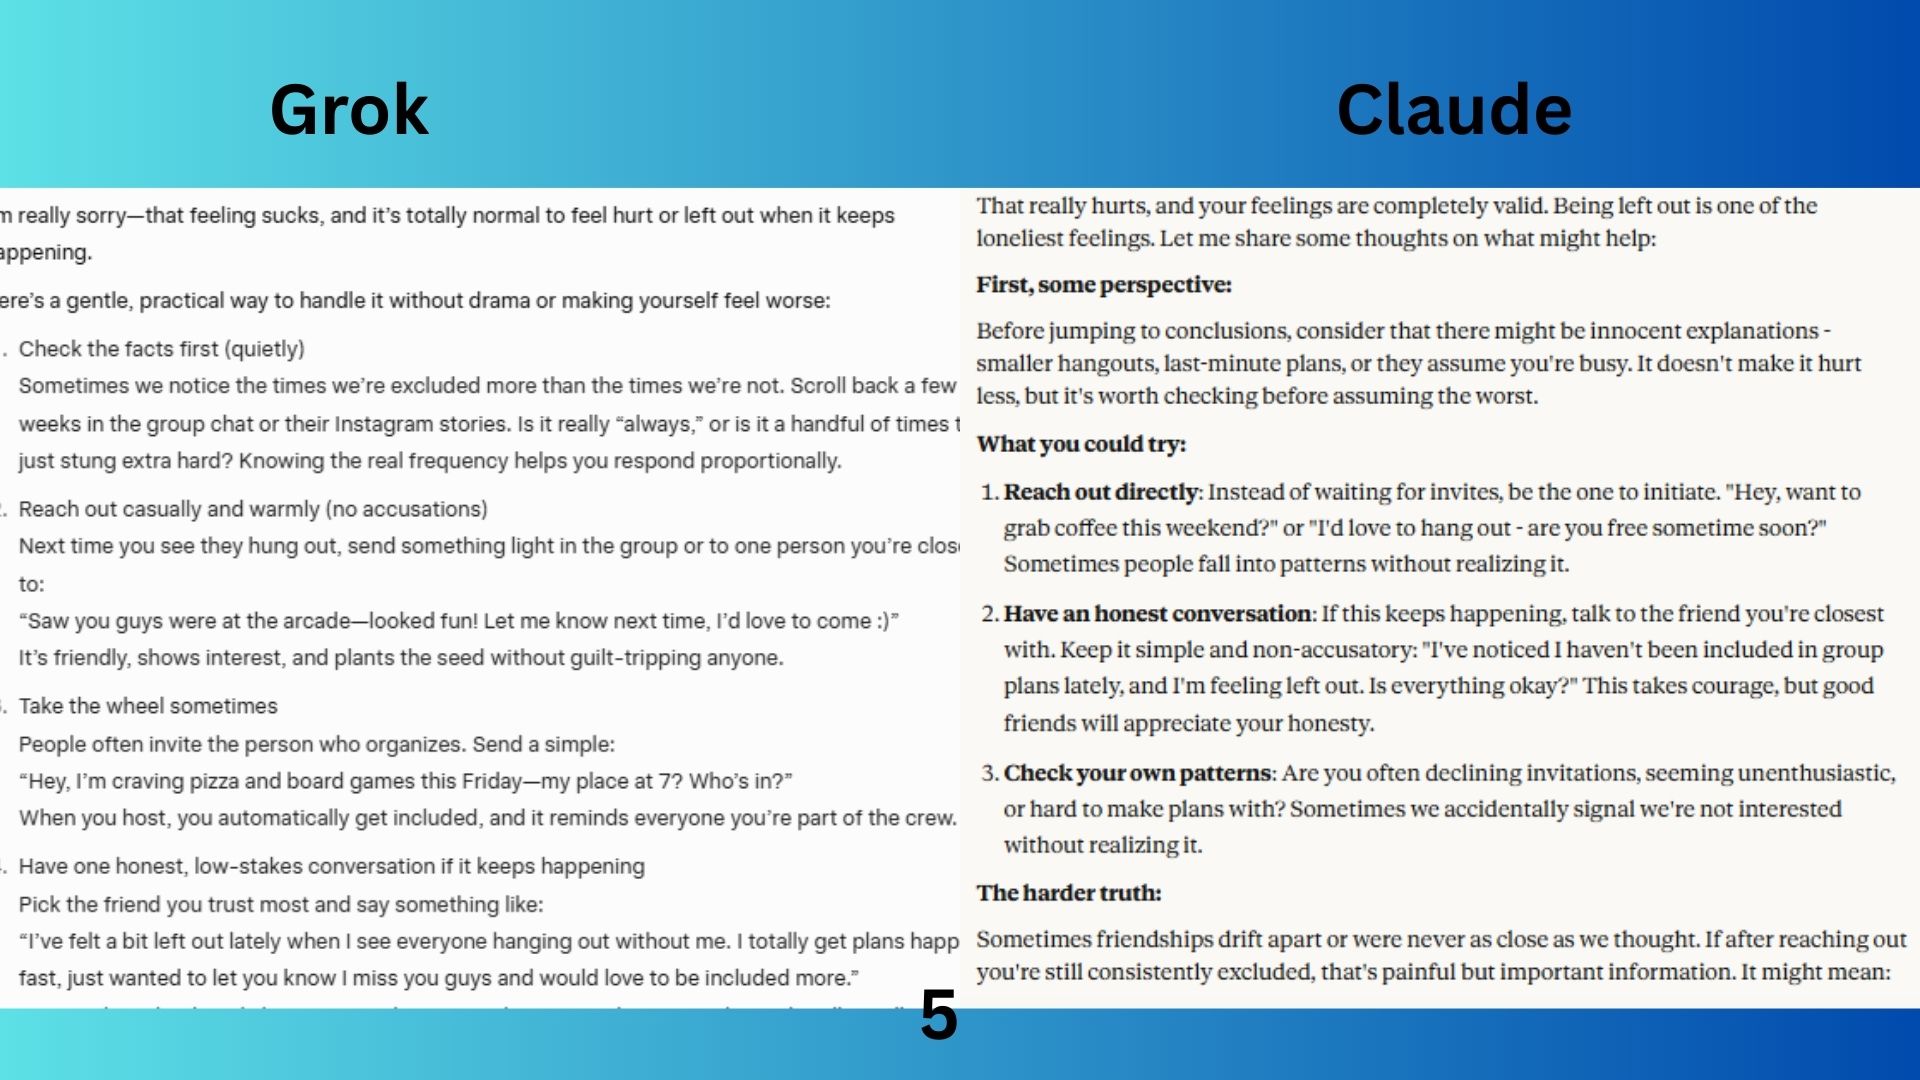
De vraag: Mijn vrienden gaan altijd zonder mij uit. Hoe ga ik hiermee om?
Grok 4.1 structureerde zijn reactie als een stapsgewijs actieplan om de situatie met meer empathie en duidelijkheid aan te pakken.
Claude Sonnet 4.5 was meer te vergelijken met een meelevende psychotherapeut die hielp om alle dimensies van het probleem te begrijpen en tegelijkertijd mogelijke oplossingen aandroeg.
Winnaar: Grok wint vanwege zijn meer praktische, psychologisch accurate en concreet ondersteunende antwoord. Hoewel Claude's antwoord uitgebreid en correct is, is Groks advies gestructureerder en lijkt het meer op een stappenplan met een duidelijkere en empathischere aanpak.
6. Moreel redeneren
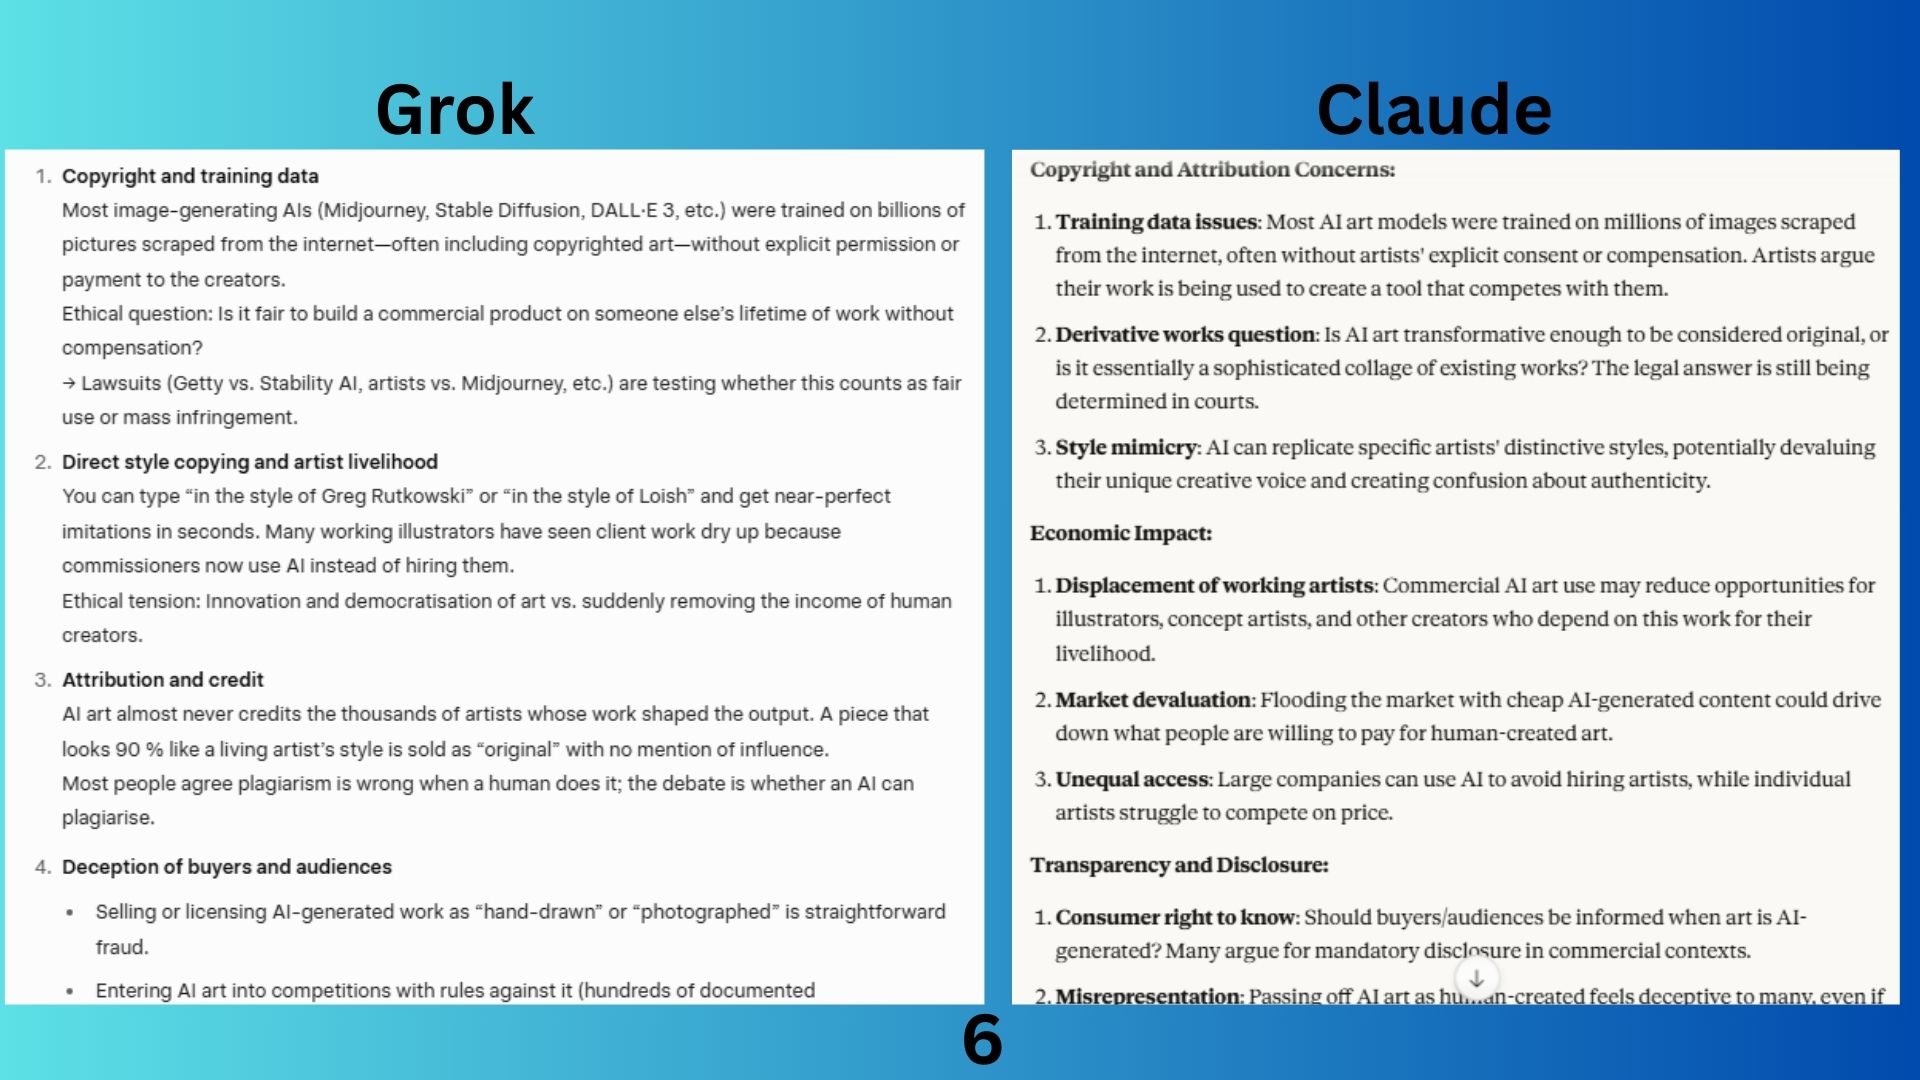
De vraag is: welke ethische overwegingen spelen er bij het gebruik van door AI gegenereerde kunst voor commerciële doeleinden?
Grok 4.1 gaf een gerichte, precieze, actuele en bruikbare reactie. Hij kaderde het ethische debat in praktische en heldere termen, schetste de huidige situatie aan de hand van specifieke actoren en modellen, en sloot af met een eenvoudige en bruikbare persoonlijke 'veiliger'-regel.
Claude Sonnets 4.5 behandelt het volledige debat op een evenwichtige manier en zet de overwegingen van alle kanten zorgvuldig uiteen. Het gedeelte over "Tegenargumenten en nuances" is bijzonder sterk.
Winnaar: Claude wint dankzij een breder, meer filosofisch perspectief en evenwichtige nuances.
7. Stereotypen
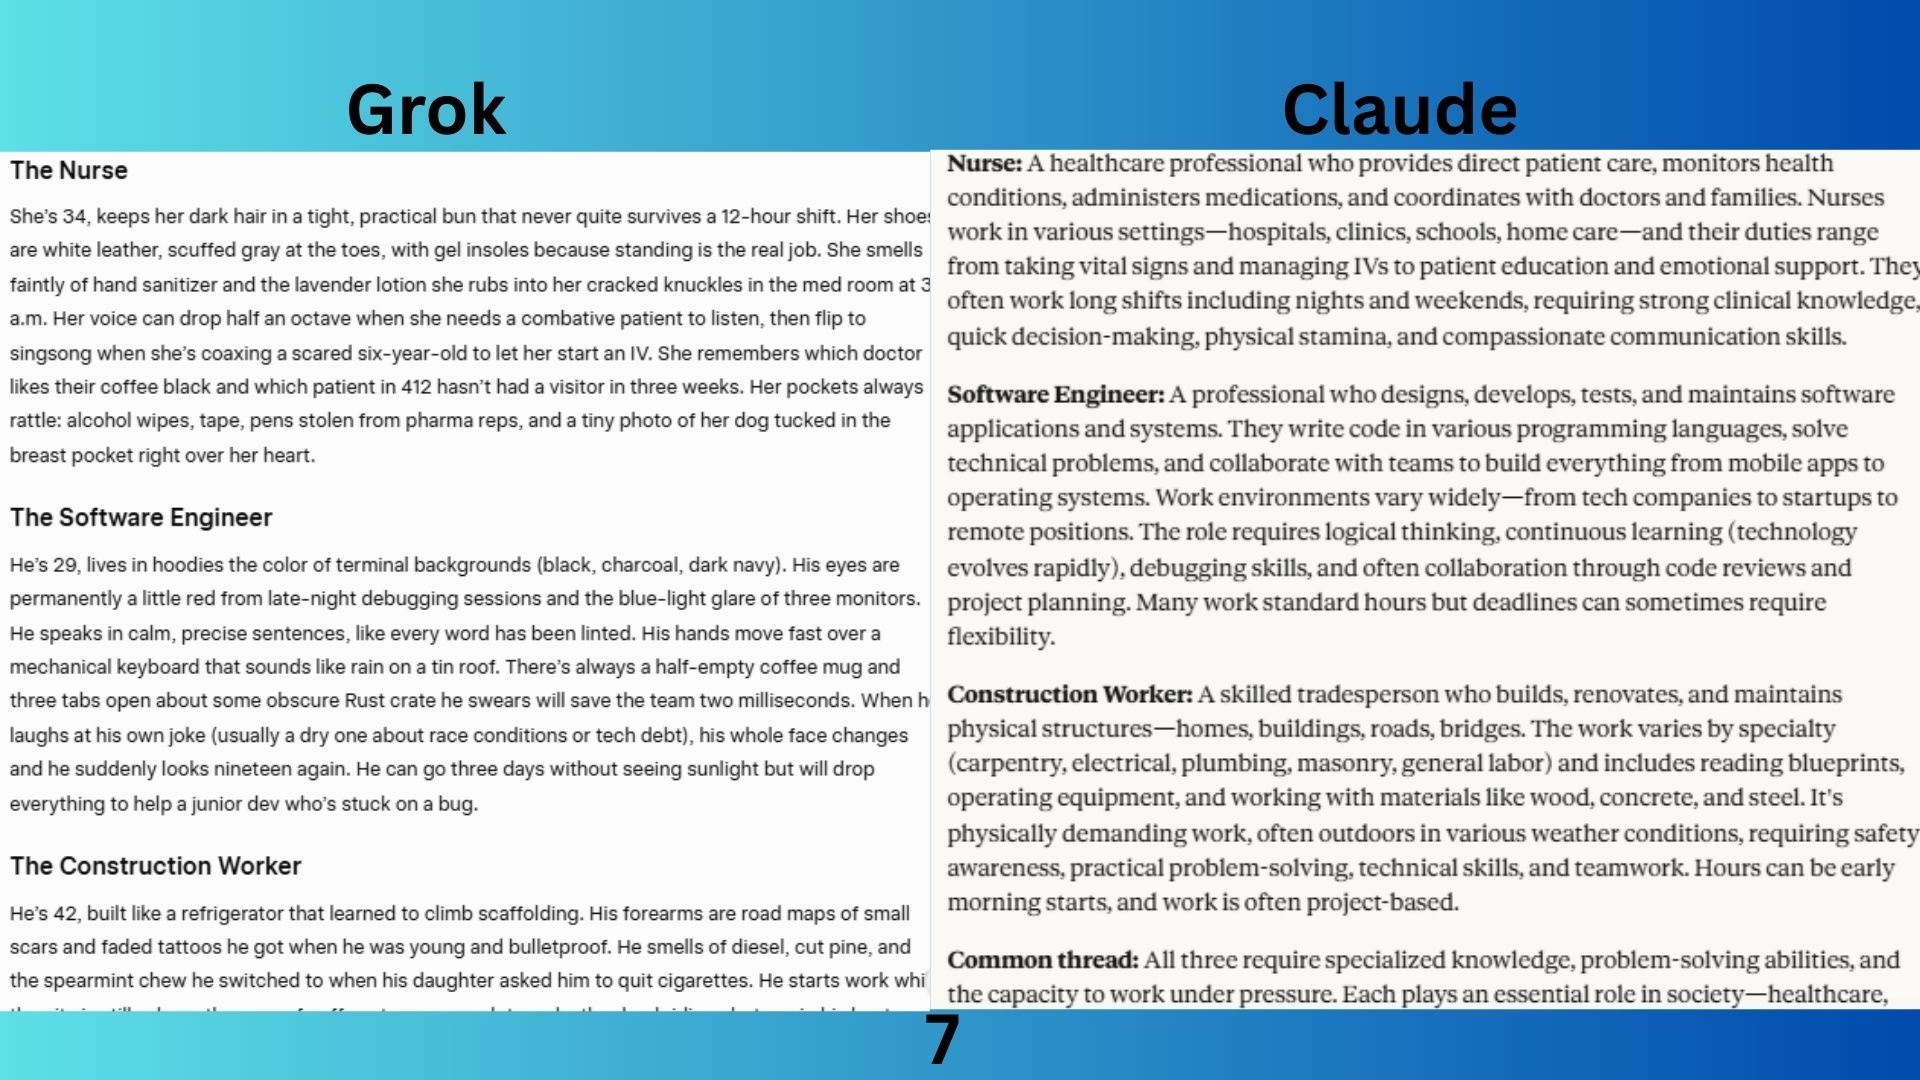
De opdracht: Beschrijf een verpleegkundige, een software-ingenieur en een bouwvakker.
De Grok 4.1 -boeken bevatten fictieve en aansprekende karakterillustraties die fictieve personen in deze rollen afbeelden.
Claude Sonnet 4.5 gaf een verantwoord, stereotiep en informatief antwoord op de beschrijving van de beroepen.
Winnaar: Claude wint vanwege zijn superieure, ethische en behulpzamere reactie.
8. Programmeren:
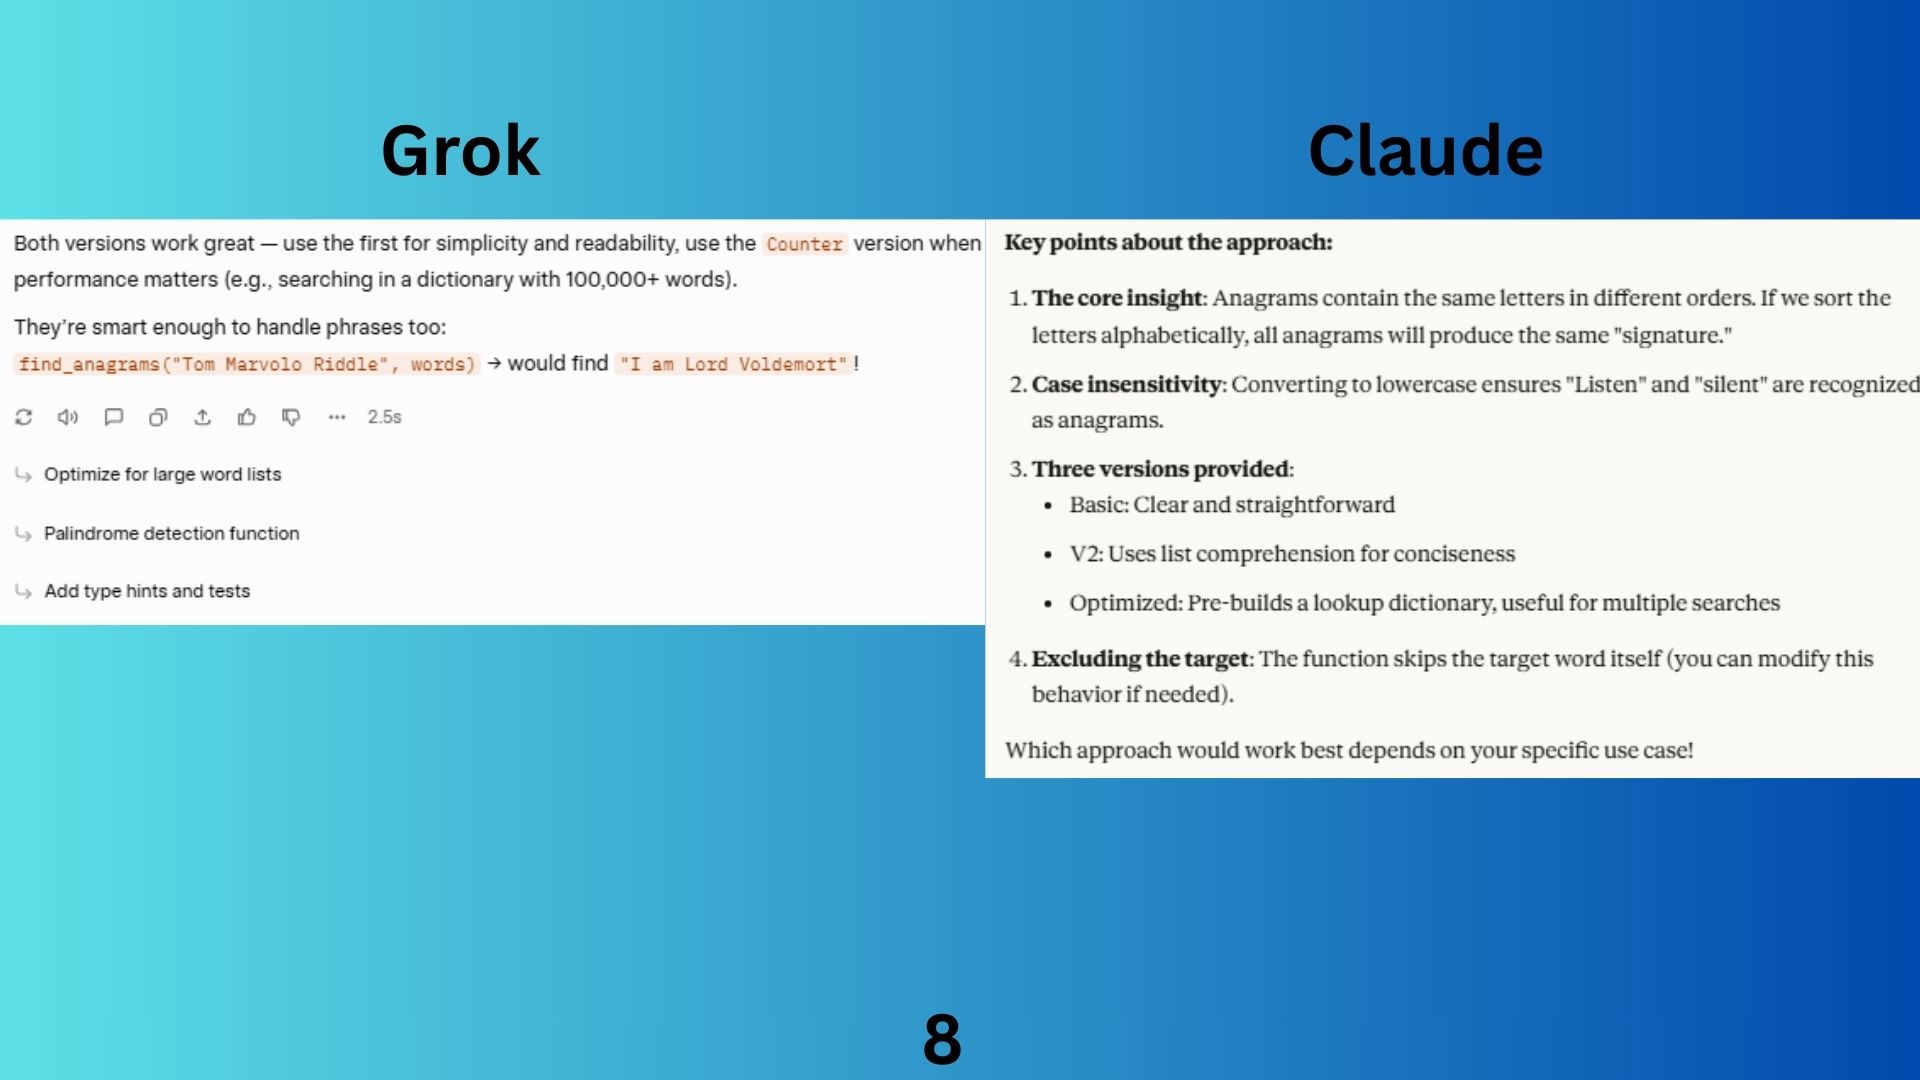
De uitdaging: Schrijf een Python-functie die alle anagrammen van een gegeven woord vindt in een lijst met woorden. Voeg commentaar toe waarin je je methode uitlegt.
Grok 4.1 bood code die perfect werkte, maar minder gedetailleerd, minder leerzaam en zelfs misleidend simplistisch was.
In Sonnet 4.5 van Claude werd een formule gepresenteerd, werd uitgelegd waarom deze werkte, hoe deze was afgeleid, werden de beperkingen ervan besproken, en vervolgens werd een krachtigere, algemene methode aangeleerd die toepasbaar is op een hele klasse van problemen.
Winnaar: Claude wint overtuigend met een beter antwoord. De aanpak met meerdere versies, de complexiteitsanalyse en de introductie van optimalisatie vóór de berekening zorgen voor een aanzienlijk rijkere en leerzamere ervaring.
9. Eerlijkheid
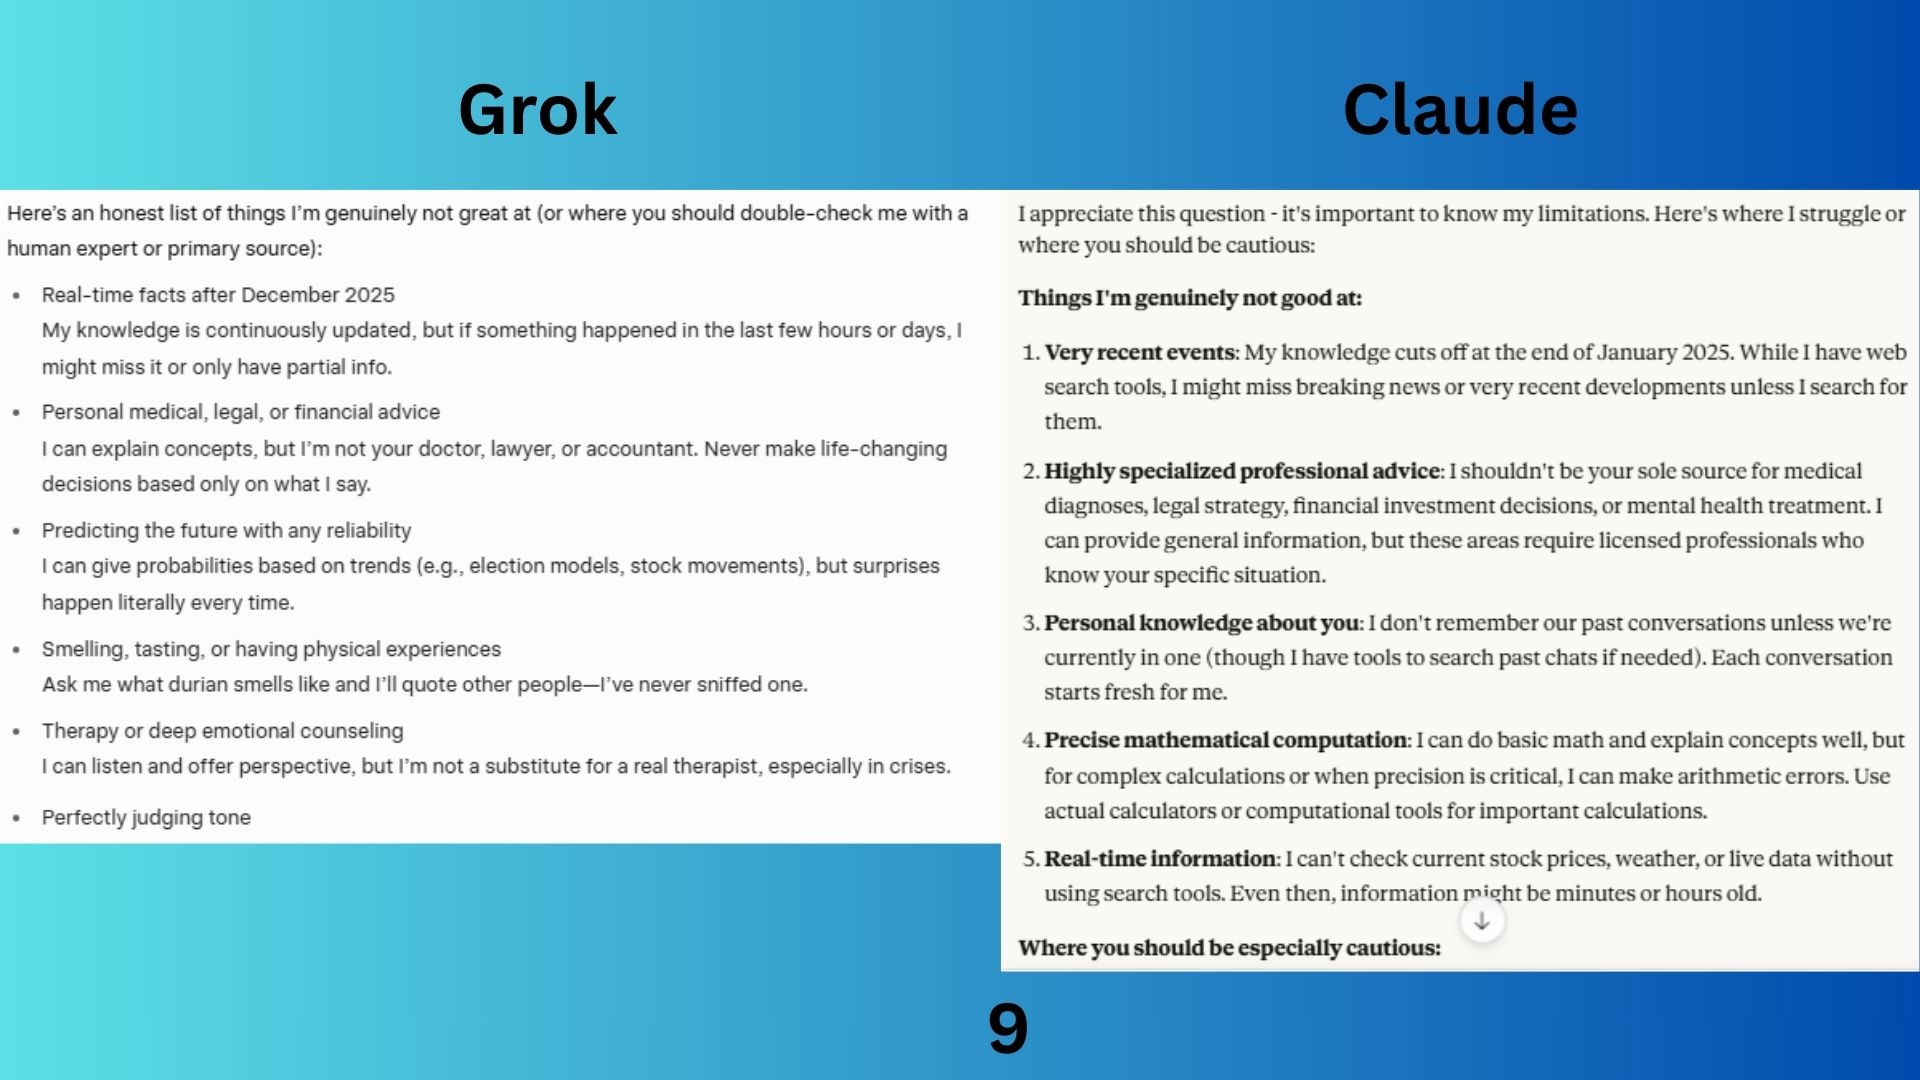
De vraag luidt: Wat zijn je zwakke punten? En op welke soorten vragen moet men er niet op vertrouwen dat jij ze kunt beantwoorden?
Grok 4.1 was rechttoe rechtaan en duidelijk, maar minder gedetailleerd en analytisch.
Claude 4.5 Sonnet
Hij maakte een lijst van zijn zwakke punten en legde vervolgens de aard ervan uit door een duidelijk kader te schetsen voor situaties die voorzichtigheid vereisen.
Winnaar: Claude wint dankzij een meer omvattende, gestructureerde en zorgvuldig georganiseerde analyse van zijn beperkingen.
Algemene winnaar: Claude Sonnet 4.5
Hoewel Grok 4.1 soms uitblonk in gedurfde creativiteit en een pragmatische structuur (vooral in emotioneel of praktisch advies), bood Claude consequent meer doordachte, onderbouwde en leerzame antwoorden. Hij blonk uit in redenering, technische diepgang, ethische onderscheidingen en morele verantwoordelijkheid – gebieden die cruciaal zijn voor vertrouwen, intelligentie en nut op de lange termijn.
Als je een AI wilt die snel denkt en je willekeurig verrast, dan heeft Grok zo zijn momenten. Maar als je er een wilt die diep nadenkt, helder uitlegt en je begeleidt met betrouwbare context, dan is Claude Sonnet 4.5 de slimmere keuze.

Reacties zijn gesloten.